AI 编程实战与 Linux 工作环境
AI Programming and the Linux Workspace
前半用真实聊天、代码审查与 VS Code 调试练习 AI 局部辅助;后半理解 Linux 的历史、内核与发行版,并练习独立的终端小例子。
本讲结束后你应当能
- 自己分析并实现主体,通过聊天向 AI 请求局部代码帮助与调试
- 保存候选并运行独立检查,用具体失败反馈继续协作
- 阅读差异,解释核心代码,记录真实生成与验证范围
- 理解 Unix、GNU 与 Linux 的关系,以及内核与发行版的区别
- 区分终端、shell 与 Python,使用简单命令完成定位、计数和搜索
- 自己操作 VS Code 调试器,用变量、调用栈与运行结果核对建议
本页目录
本讲有两个部分:前半学习 AI 辅助编程与 debug,后半认识和使用 Linux。目录统计函数只作为前半的课堂例子;Linux 部分从视频开始,再用独立的 hello.py 和文件操作练习终端。
正文先给出课堂主线,完整参考实现、目录读取外壳和原有深入材料放在后面的课后补充。
第一部分:AI 辅助编程与 debug
先理解 LLM:它为什么能回答、写代码和解释报错
LLM(大语言模型) 是含有大量可学习数值的神经网络。以本课讨论的生成式语言模型为例,训练不需要开发者为每道问题手写答案规则,而是通过大量例子调整这些数值,学习文字、代码结构及上下文之间的关联。
训练和使用是两个过程
- 预训练:文字、代码、说明文档等资料提供预测练习。模型根据已有上下文预测后续片段,训练过程比较预测与真实资料,并调整模型参数。为了做好大量预测,模型可以学到语法、知识关联、接口用法和代码结构;这些能力并不等于对所有问题都有正确答案。
- 指令与反馈训练:用指令/回答示例和反馈等进一步改善遵循要求、解释和回答的方式。不同模型的训练配方不同,这里只介绍共同思路。
- 使用时:当前问题、相关代码、报错和对话上下文输入已训练的模型,模型生成本次回答。普通聊天中补充一段代码,通常是在改变这次输入,不是马上重训模型参数。
Stanford CS146S 的 LLM 原理课件将模型生成、训练和实际能力分开说明;本课保留这条逻辑,不要求记模型层数、向量维度或历史参数量。
回答怎样逐步生成
token 是模型处理的文本片段,可能是一个词、词的一部分、标点或其他片段,具体切分由 tokenizer 决定,不能当作“一个汉字”或“一整个单词”。生成时,模型结合当前可见上下文,对下一个 token 给出概率分布;选出片段、接回上下文后,再生成下一个,直到停止。选择方法可以有随机性,不是永远只选最高概率项。
例如,The sky is 可以接不同描述。接入新内容以后,后续预测还会使用更新后的上下文。这个过程是解释生成的示意,不是某个模型的实测概率表。模型也不只是查上一个词的词频。3Blue1Brown 的可视化用连续画面解释了这种生成循环。
代码也是有结构的文本。代码和文档训练帮助模型关联语法、接口、自然语言说明与实现方式,指令训练帮助它把“解释这个错误”或“建议局部修改”组织成回答。因此,同一个模型可以回答问题、解释代码和生成片段。写出了代码或解释,不代表 Python 已执行,也不代表它知道当前电脑的文件、解释器和全部任务规则。 实际运行结果需要另外获取。
LLM、聊天应用和 coding agent
| 层次 | 做什么 |
|---|---|
| LLM | 根据输入上下文生成输出 |
| 聊天应用 | 组织提示、对话与回答;用户可粘贴代码、报错和相关资料 |
| Coding agent | 应用程序可将模型的工具请求交给文件、终端等工具,把执行结果送回模型继续工作 |
工具调用是应用程序实际执行的动作,不是模型写出“我已经测试”这句话就自动产生结果。Berkeley 的 agent 课程用动作与观察循环解释这个区别,MIT Missing Semester进一步把文件和终端工具放入实际开发流程。
本周 Level 1 采用聊天式局部帮助:可以请 AI 解释代码/报错、生成或修改局部代码,自己编辑、整合、运行和验证;不能生成题目完整解,不使用 agent 操作项目。Level 2 才开放完整实现和 agent 自动修改、运行与纠错。聊天窗口的外观不决定它属于哪种协作方式。
四种有用的局部请求
- 读懂代码:请解释每轮循环中的变量变化,再自己逐行核对。
- 生成片段:指出修改位置、范围与约束,只请求当前困难的一小部分。
- 诊断报错:提供最小输入、相关代码、完整回溯、版本和预期,先解释原因再讨论修改。
- 审查检查:请补充遗漏的边界情形,预期仍由任务要求决定,不能只改测试适应错误结果。
这些是协作方法,不是强制提示词格式。Stanford 的提示课件通过具体例子比较上下文差异;本课沿用“同一个问题、材料更充分”的比较,不要求背诵提示技巧名称。
课堂任务:审查文件类型统计函数
用教师提供的文件类型统计函数练习读代码、发现问题和局部修改。先确定规则,再查看 candidates/first.py;inventory.py 是完整参考,check_inventory.py 提供独立检查。这是课堂阅读与运行材料,不增加实验提交。
下载课堂项目 ZIP。包内还包括后面调试演示使用的 factorial.py 和 .vscode/launch.json。
先决定任务,再提供上下文
Level 1 允许生成或修改局部代码、解释代码与报错、辅助 debug;不允许直接生成题目对应的完整代码。 采用聊天式协作:AI 回复解释与局部建议,自己审阅、编辑文件、运行和验证。不能把让 AI 写完整解答改称“写一个函数”来绕过边界。
Level 2 才开放完整实现及 coding agent 直接新建、修改项目文件、自动运行与纠错。区分依据是实际协作方式;coding agent 即使有聊天窗口,也不因此变成 Level 1。两级都须说明使用范围并验证结果。
本例只处理文件名,不直接处理路径或文件内容。函数为 count_extensions(names: list[str]) -> dict[str, int],输入是非空文件名组成的列表,列表本身可以为空。约定如下:
- 只取最后一个点后面的后缀,并统一为小写。
- 无点、单独的隐藏文件名(如
.env)、末尾点号(如notes.)都归为"(none)"。 archive.tar.gz归gz,.config.json归json;这里统计名称后缀,不判断文件真实格式。- 重复名字逐项计数,输入列表保持不变,每次返回独立的新字典。
可以给助手下面这份课程制作者编写的示范请求:
这是我正在检查的局部代码:
ext = parts[1]
counts[ext] = counts.get(ext, 0) + 1
输入中包含 L01.PDF 和 L02.pdf,预期同属 pdf,实际分成两个键。
请解释原因,只建议 ext 的局部修改,保持输入和循环结构不变。
不要提供完整函数;我会自己整合、运行并核对。
粘贴相关局部代码、规则和实际结果即可,不必发送整个电脑目录。遇到陌生写法,要求解释或改成已经学过的语法。不要把个人作业 1 的代码交给 AI 生成或改写;它仍按 Level 0 执行。
四个真实聊天案例:材料、回复与本人核对
下面的中文请求与回答节选来自课堂实际使用的 DeepSeek Chat 对话。请求保留实际发送的代码与约束;回复节选与自己的执行结果分开记录。为复现错误而准备的代码,不等于声称该错误由 DeepSeek 生成。
1. 读懂 get 的默认值
实际发送的问题和代码:
这段代码我有点没看懂,get 后面的 0 是干嘛的?能拿第一次循环简单说说吗?

counts = {}
for ext in ["pdf", "pdf", "txt"]:
    counts[ext] = counts.get(ext, 0) + 1
回答节选:
如果字典里没有 ext 这个键,就返回 0;如果有,就返回它对应的值。
自己核对:空字典首次查找 pdf 时,get 返回 0;加一并写回后得到 {'pdf': 1}。下面逐轮打印的程序用于独立核对,并非声称 AI 已替我们运行:
counts = {}
for ext in ["pdf", "pdf", "txt"]:
    counts[ext] = counts.get(ext, 0) + 1
    print(ext, counts)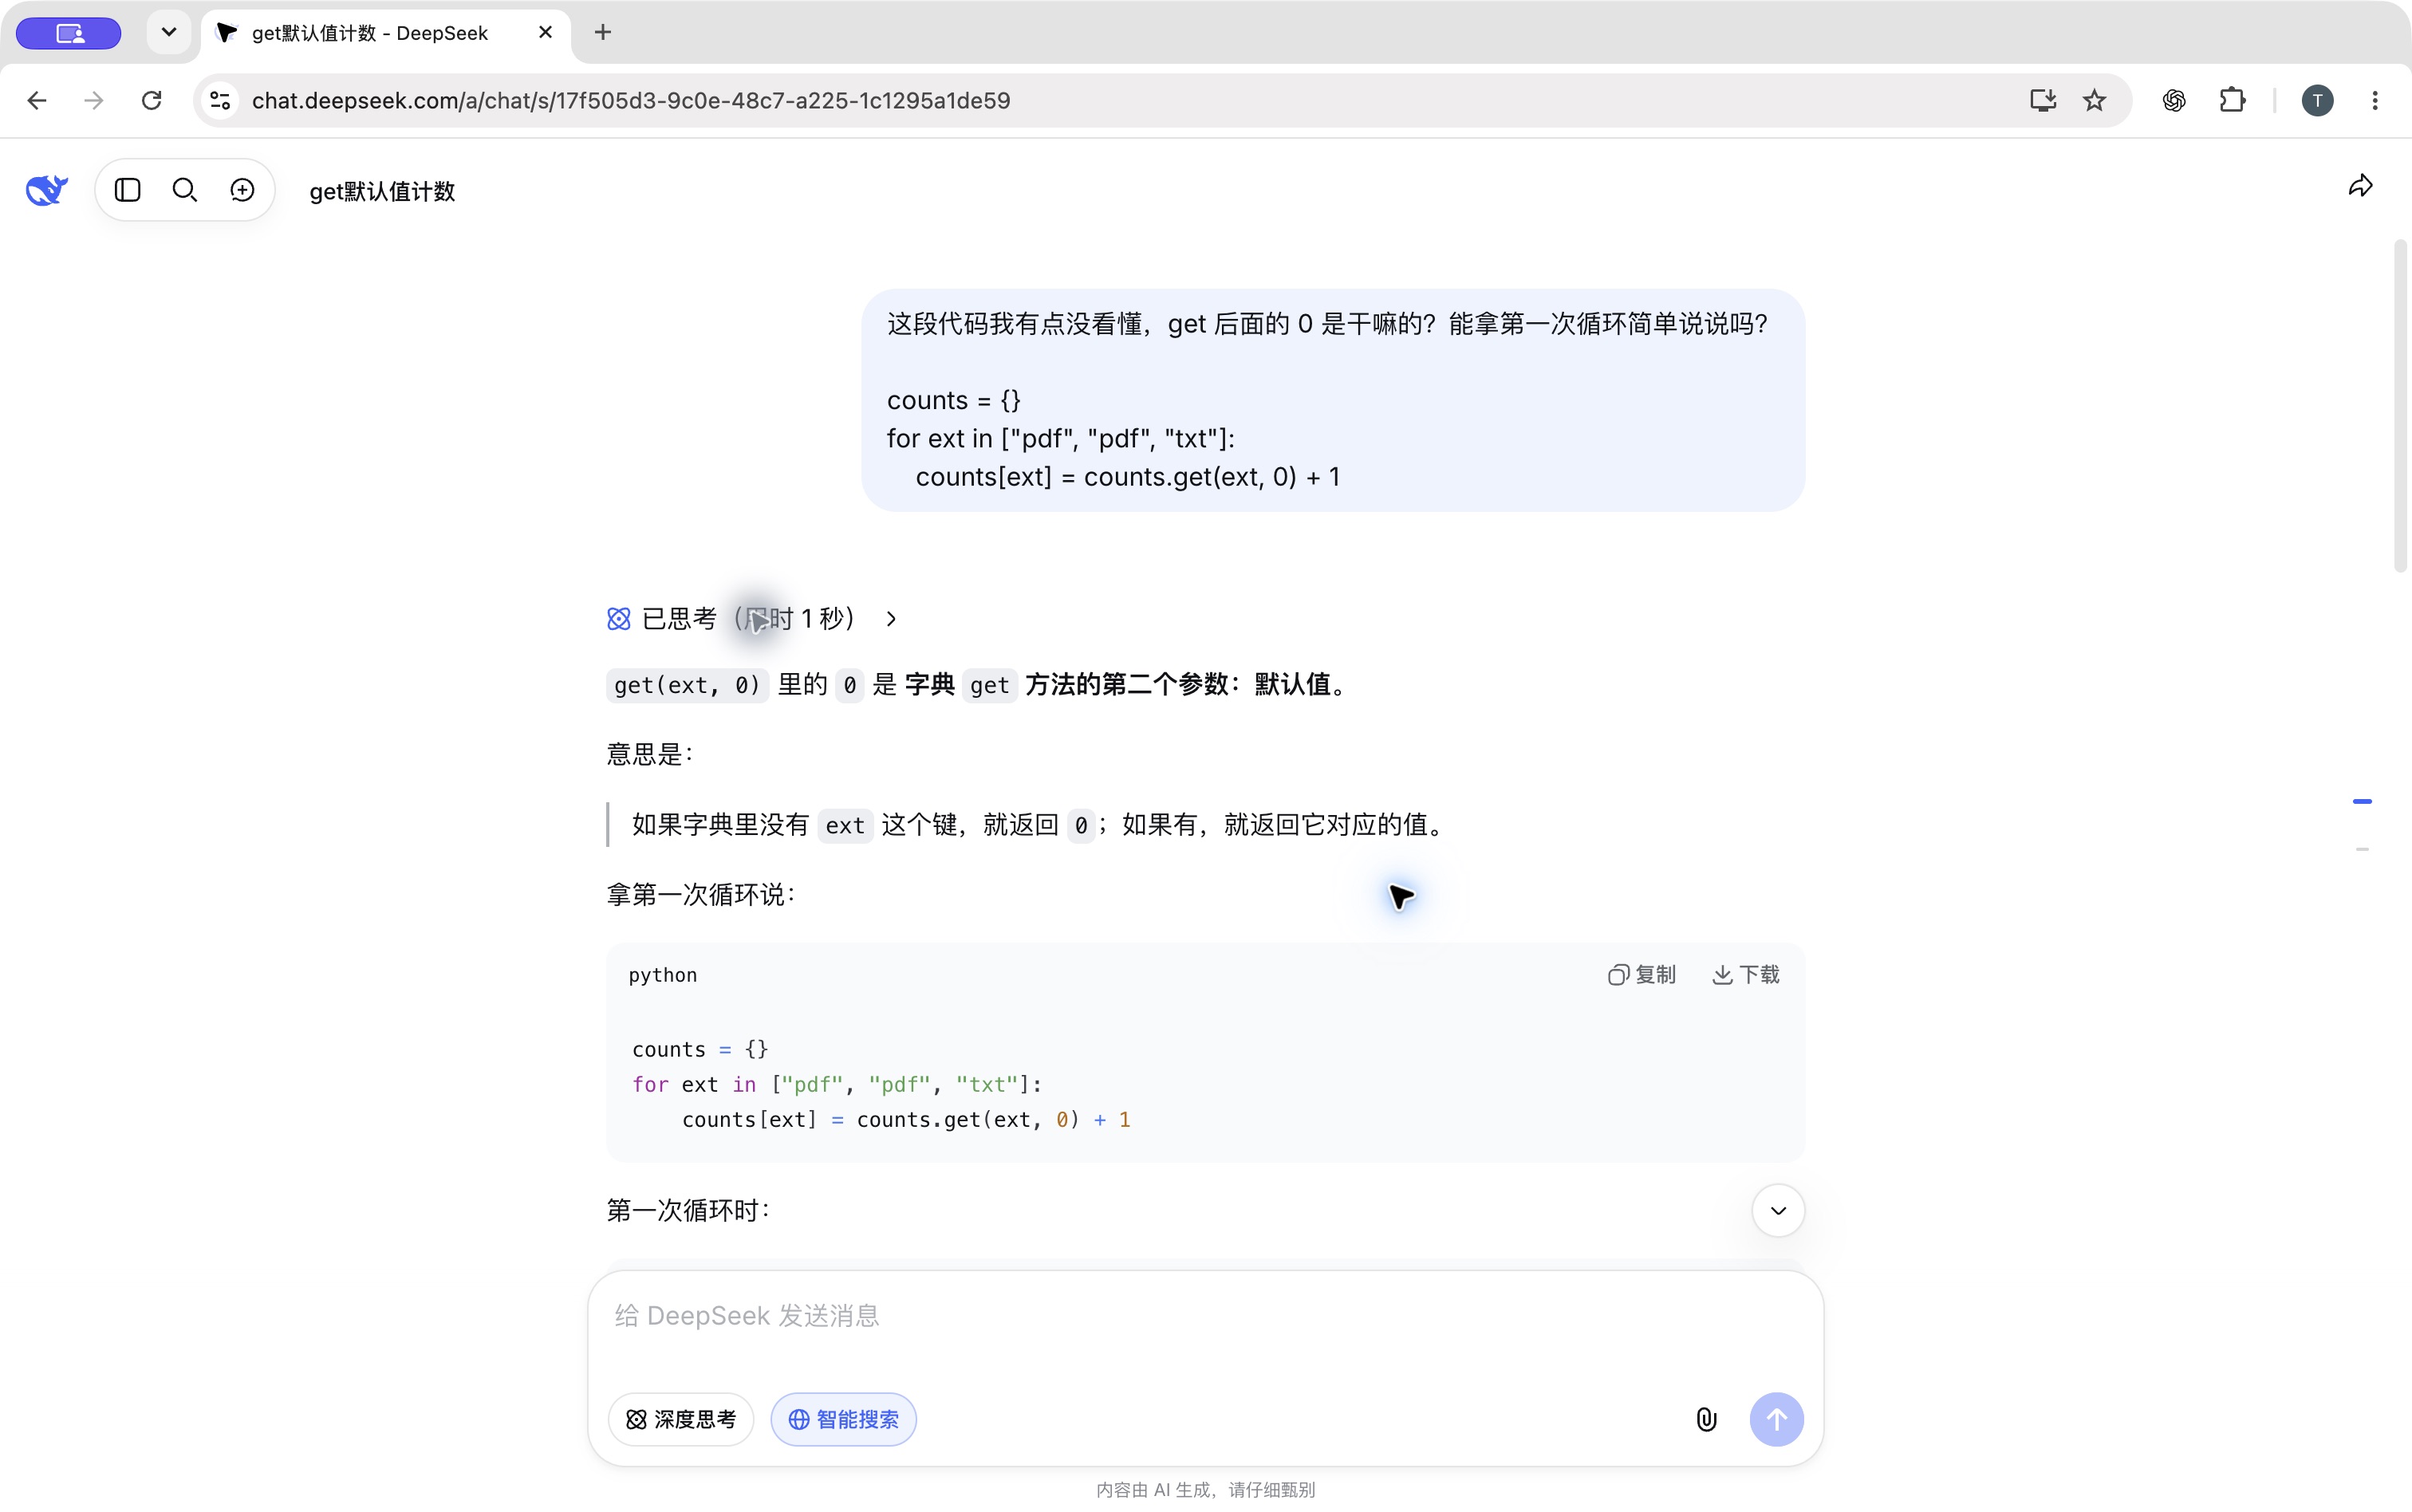
2. 补齐相邻代码,再决定局部修改
首轮真实请求只描述了大小写分组问题:
我发现 PDF 和 pdf 被分开统计了。我想把它们算在一起,是不是只要改 ext = parts[1] 这一行?其他地方先不动。这个请求没有给出相邻代码。回复建议了 lower(),还额外提出可能使用 strip()。随后补充代码、用途与空格约束:
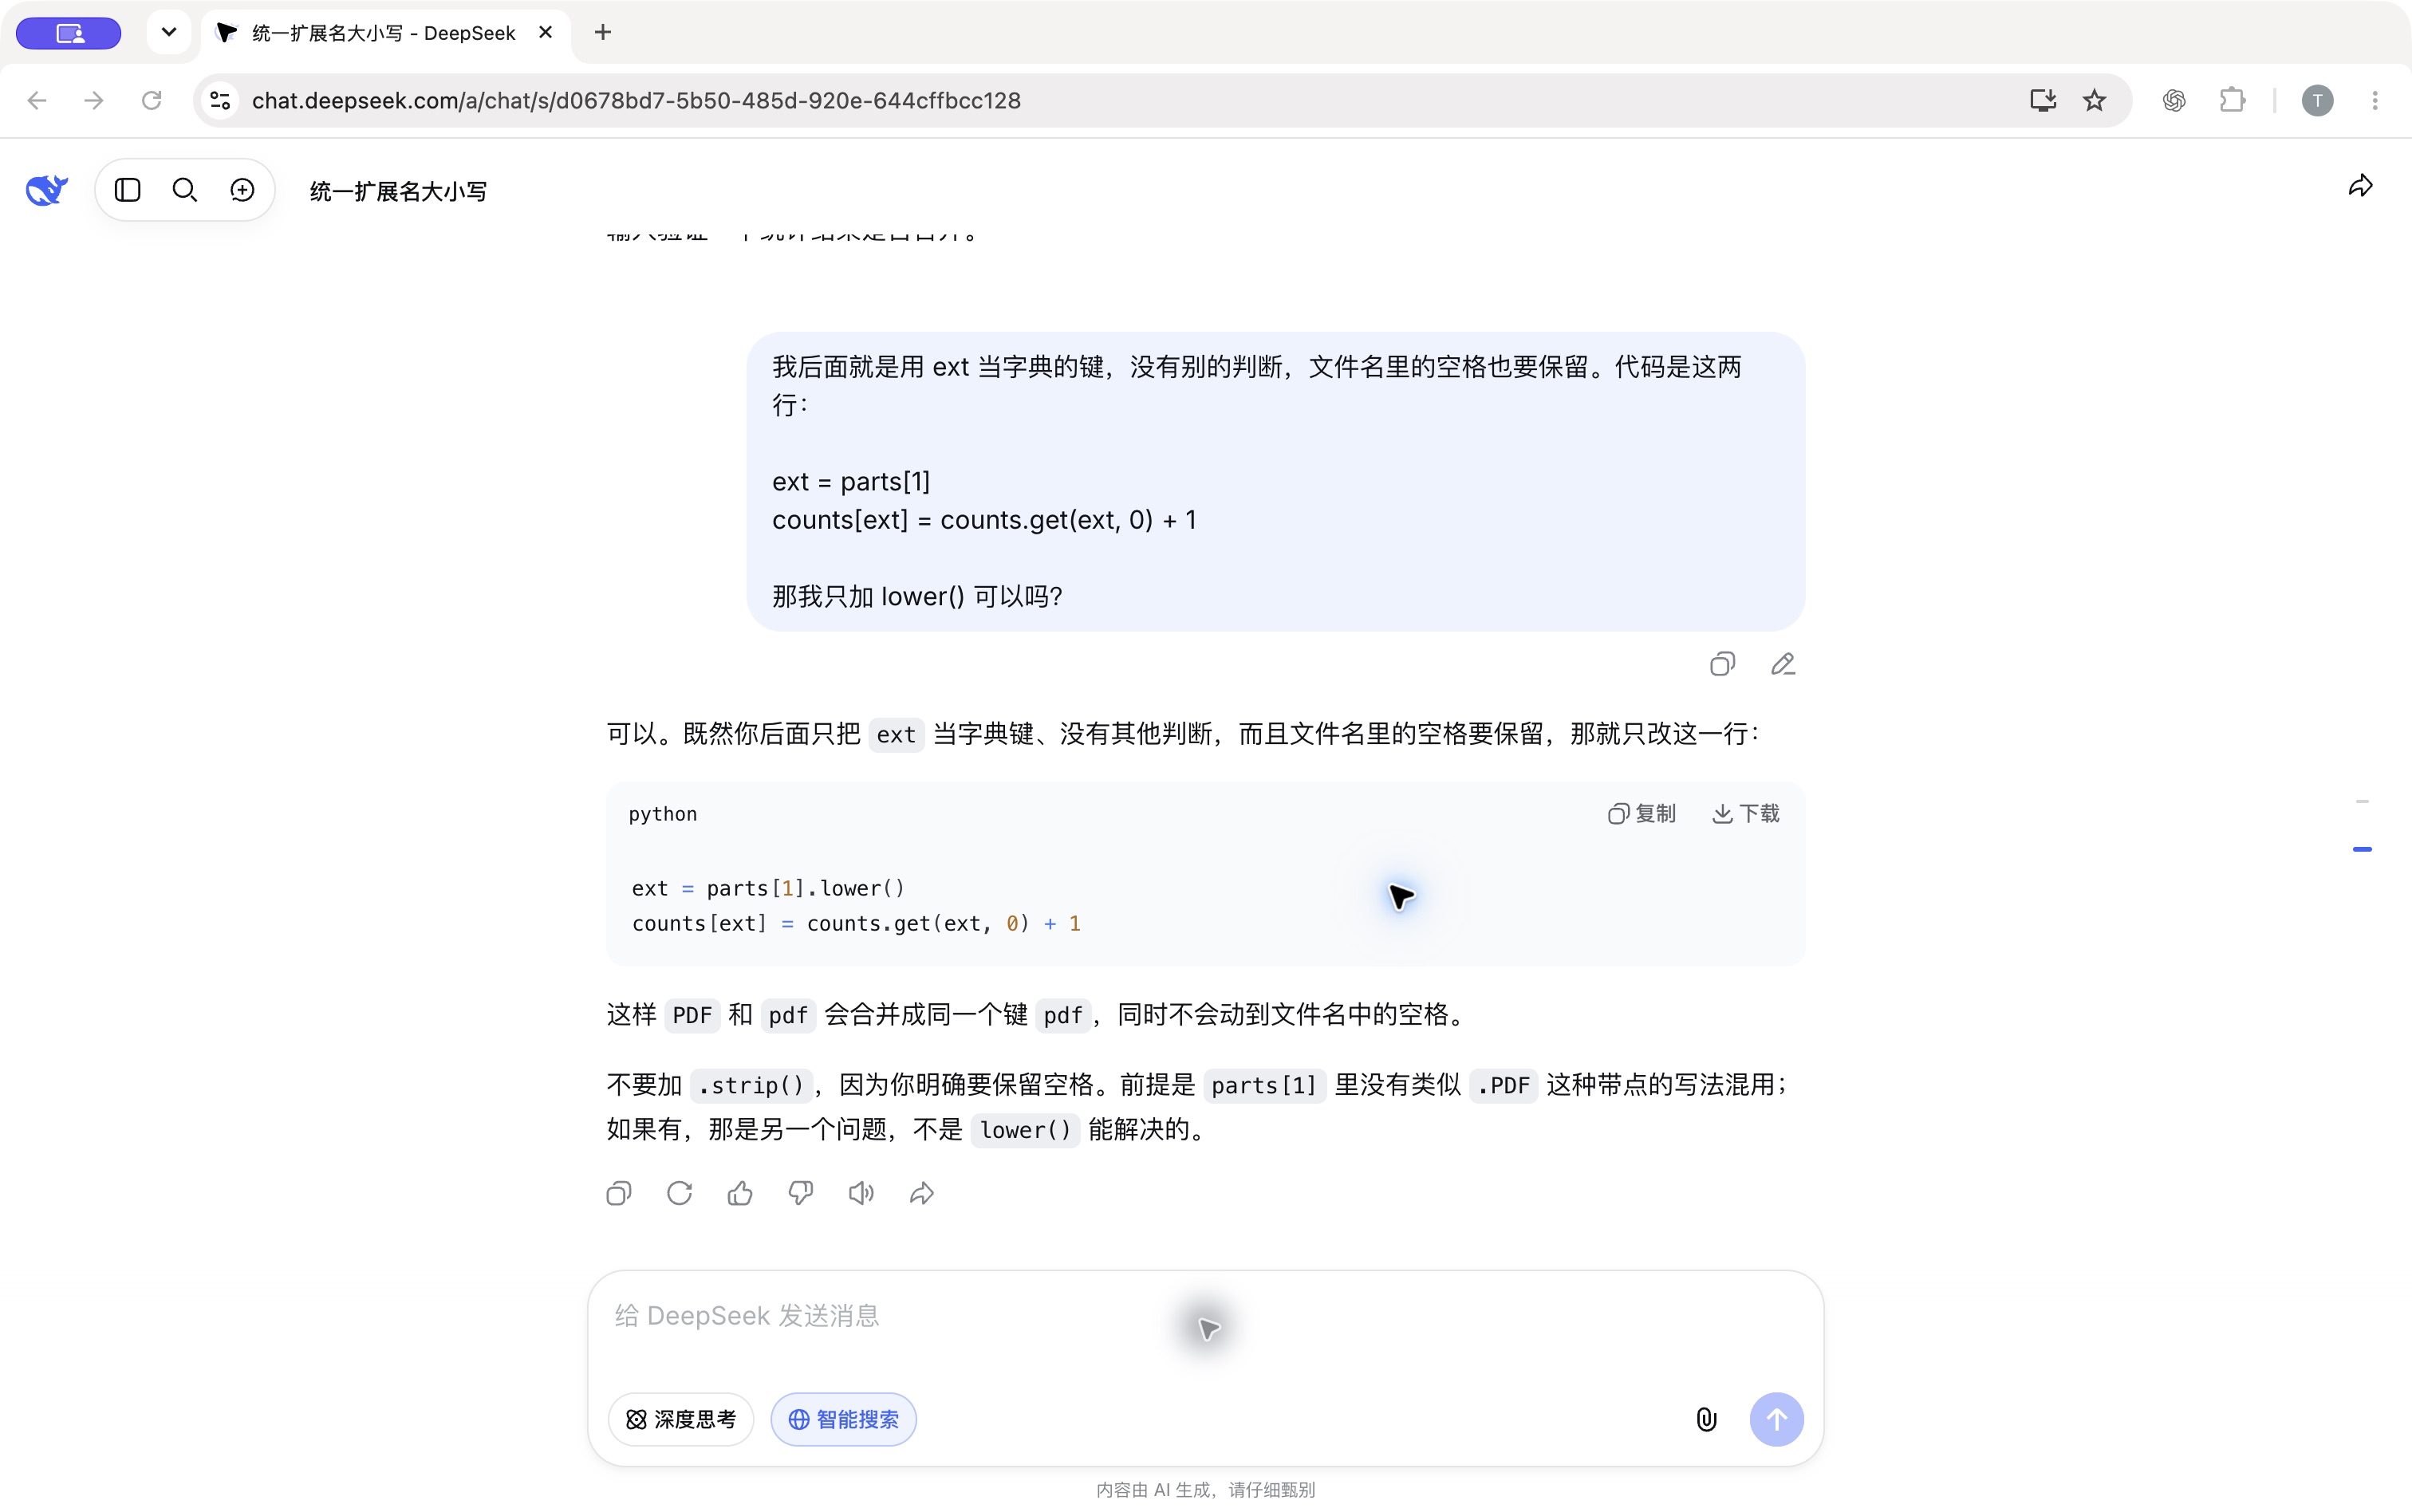
我后面就是用 ext 当字典的键,没有别的判断,文件名里的空格也要保留。代码是这两行:

ext = parts[1]
counts[ext] = counts.get(ext, 0) + 1

那我只加 lower() 可以吗?
回复节选:
这样 PDF 和 pdf 会合并成同一个键 pdf,同时不会动到文件名中的空格。 不要加 .strip(),因为你明确要保留空格。
采纳的局部修改是:
ext = parts[1].lower()lower() 产生新的后缀字符串;统计使用这个局部键,不改原文件名列表。按已有约定核对 PDF/pdf 合并,并重跑无后缀等已有检查。额外的 strip() 是否需要,应由规格决定,不因为助手提出就自动采用。
检查副作用:两个名字指向同一列表
下面这个例子说明为什么还要检查输入有没有被修改。赋值没有复制列表,两次打印都会看到第一个名字整体变小写;规范化局部后缀不需要改原列表。
def prepare(names):
    result = names
    result[0] = result[0].lower()
    return result

files = ["L01.PDF", "L02.pdf"]
print(prepare(files))
print(files)
3. 把代码、输入、预期与完整回溯一起发送
真实请求先说明 README 没有后缀,希望返回 (none),只修改相关几行,再附上以下代码:
def suffix(name):
    parts = name.split(".")
    return parts[1].lower()

print(suffix("README"))
实际一起发送的完整错误:
Traceback (most recent call last):
  File "debug_suffix.py", line 5, in <module>
    print(suffix("README"))
          ~~~~~~^^^^^^^^^^
  File "debug_suffix.py", line 3, in suffix
    return parts[1].lower()
           ~~~~~^^^
IndexError: list index out of range
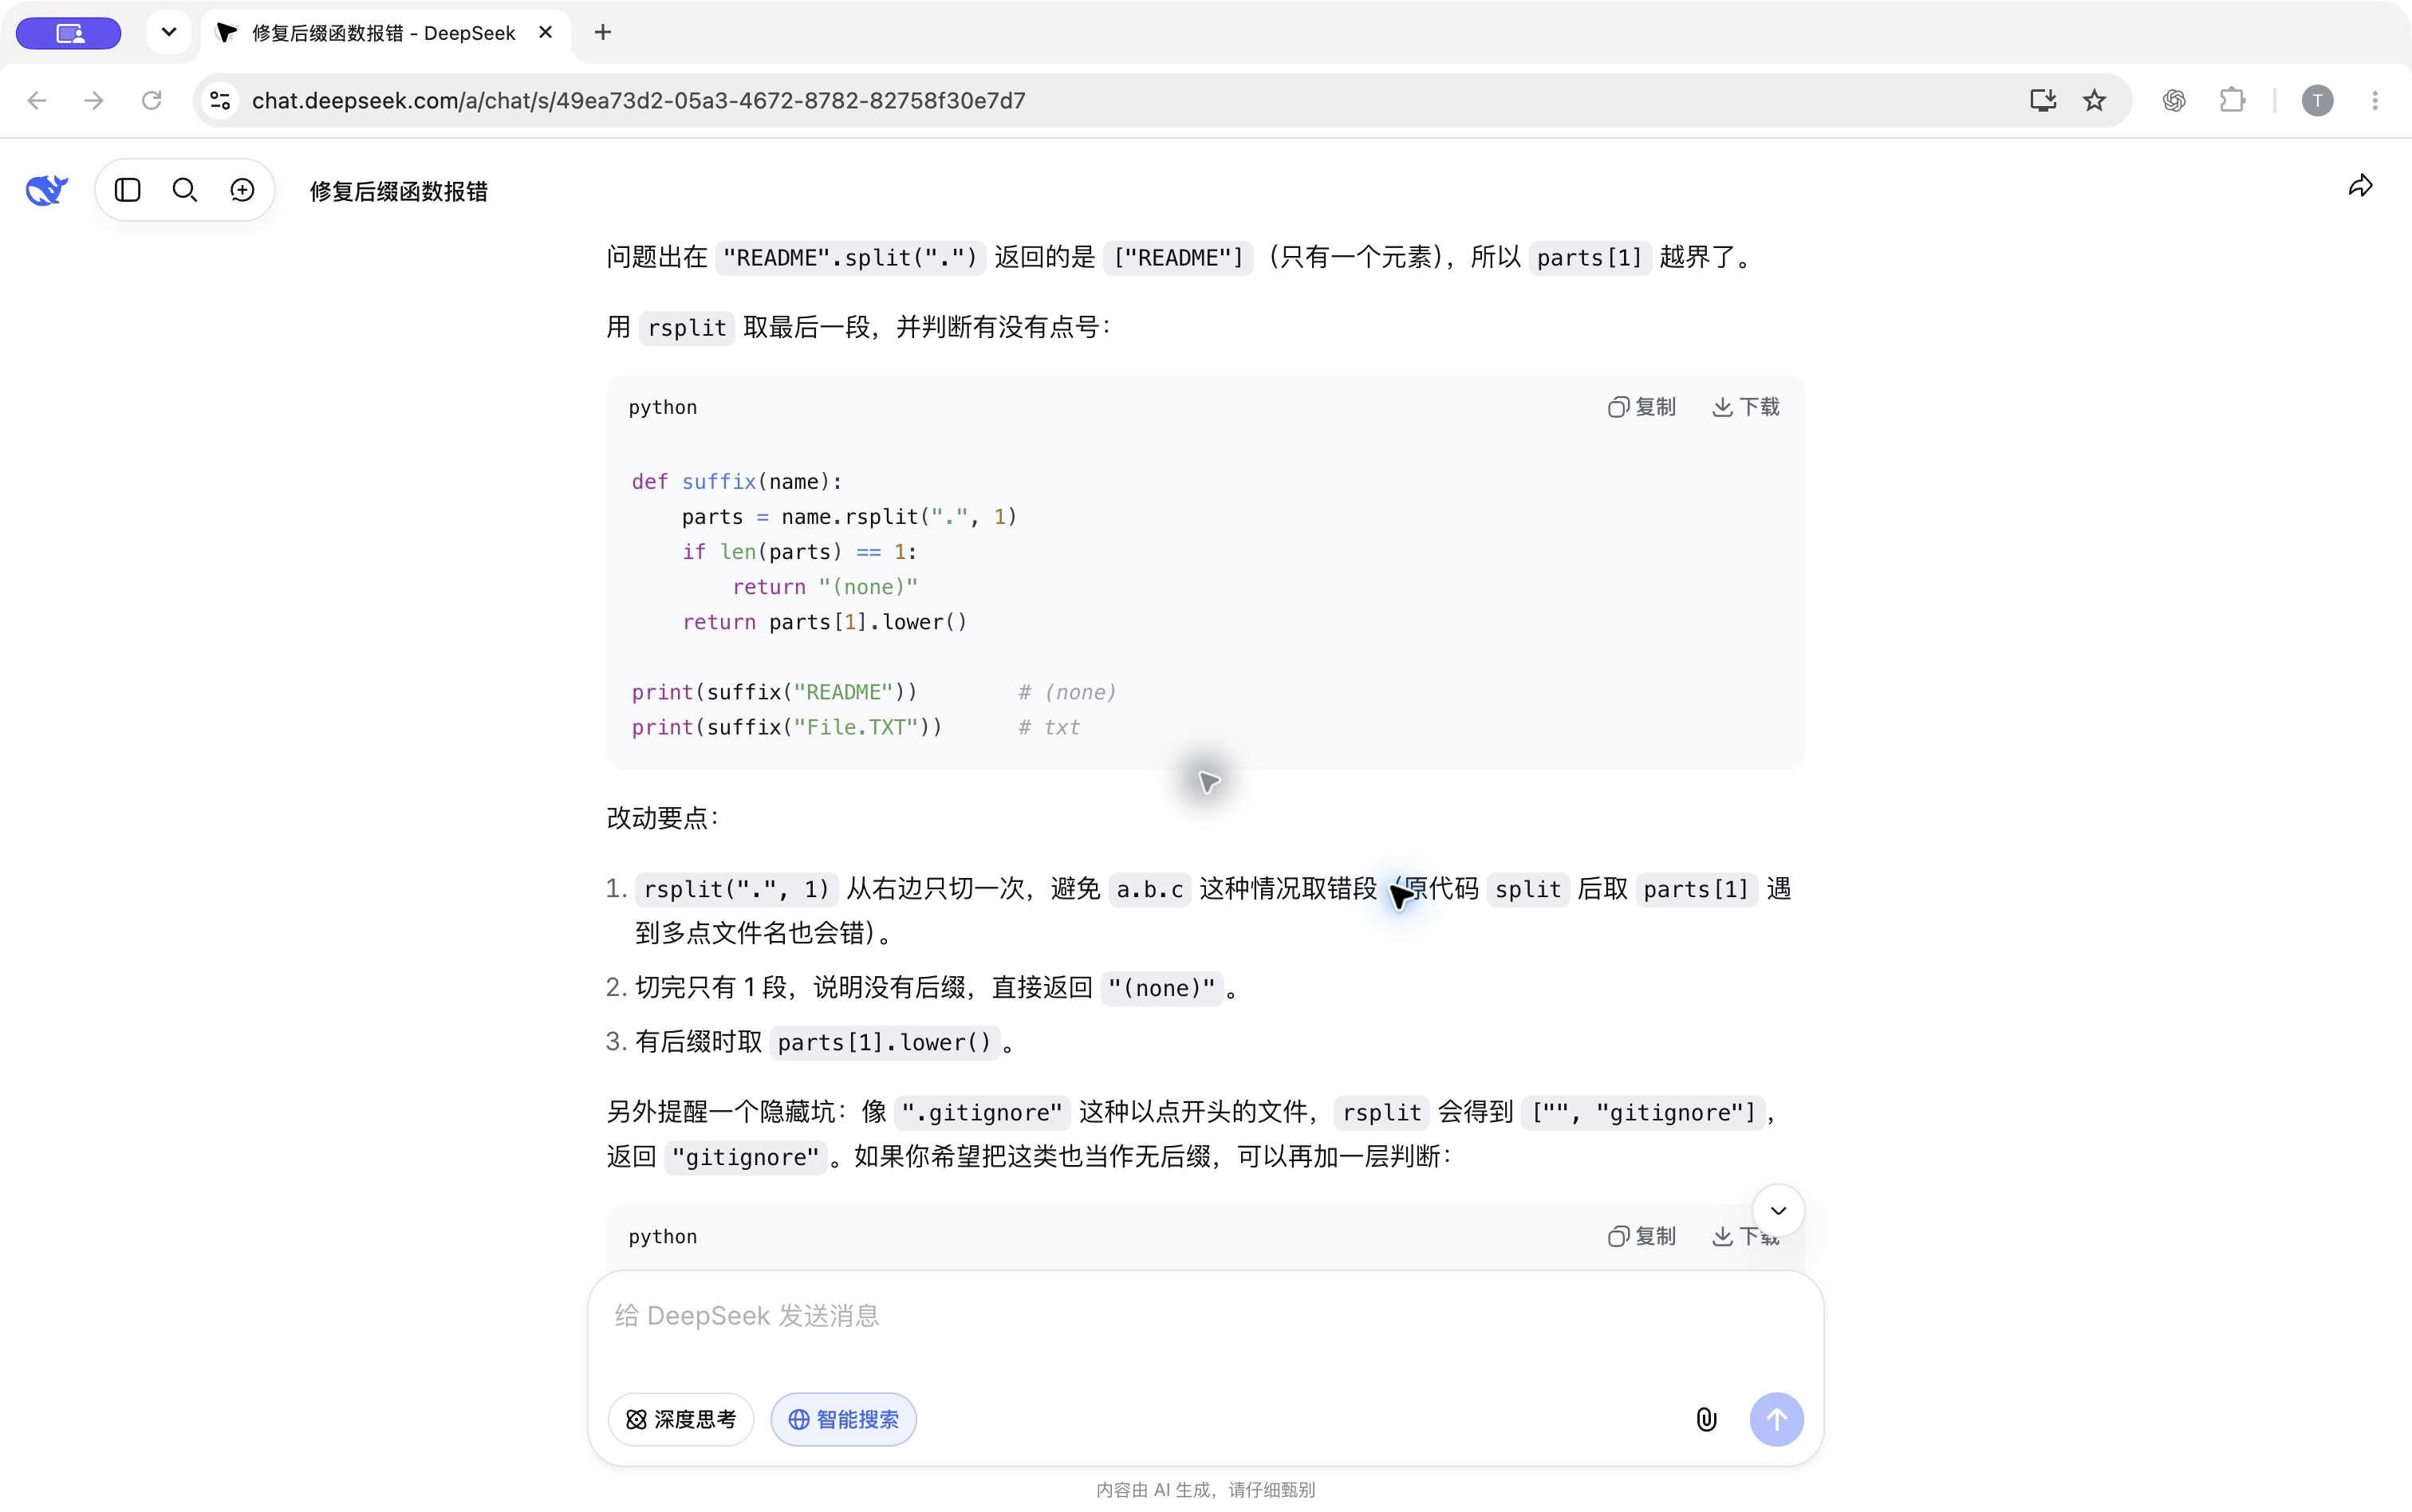
回复节选:
问题出在
"README".split(".")返回的是["README"](只有一个元素),所以parts[1]越界了。
下面是 DeepSeek 实际给出的第一版函数,加上我们自己的三个核对输入:
def suffix(name):
    parts = name.rsplit(".", 1)
    if len(parts) == 1:
        return "(none)"
    return parts[1].lower()

for name in ["README", "File.TXT", "notes."]:
    print(name, repr(suffix(name)))
实际输出:
README '(none)'
File.TXT 'txt'
notes. ''
README 的异常修好了,但 notes. 返回空字符串;已有规则要求它也归 (none),所以这个修复仍不完整。解释能对应报错,不代表所有返回值已满足约定。
4. 请 AI 补充测试思路,区分它与代码审查
实际请求给出了规格和已经试过的输入,没有发送函数实现:
我写了个统计文件后缀的小函数,PDF 和 pdf 要算一类,没有后缀的算 "(none)",也不能改原来的文件名。我目前只试过 ["a.PDF", "b.pdf"],结果是 {"pdf": 2}。这就算测全了吗?还应该先试哪两种情况呀?回答节选:
所以“先试哪两种”:无后缀 和 隐藏文件/多点文件名。
这只能提供测试方向,不能证明某份函数实现正确。下列结果来自我们自己运行完整参考实现;无后缀、隐藏文件和多点名字的预期仍应由任务规则确定:
README {'(none)': 1}
archive.tar.gz {'gz': 1}
.bashrc {'(none)': 1}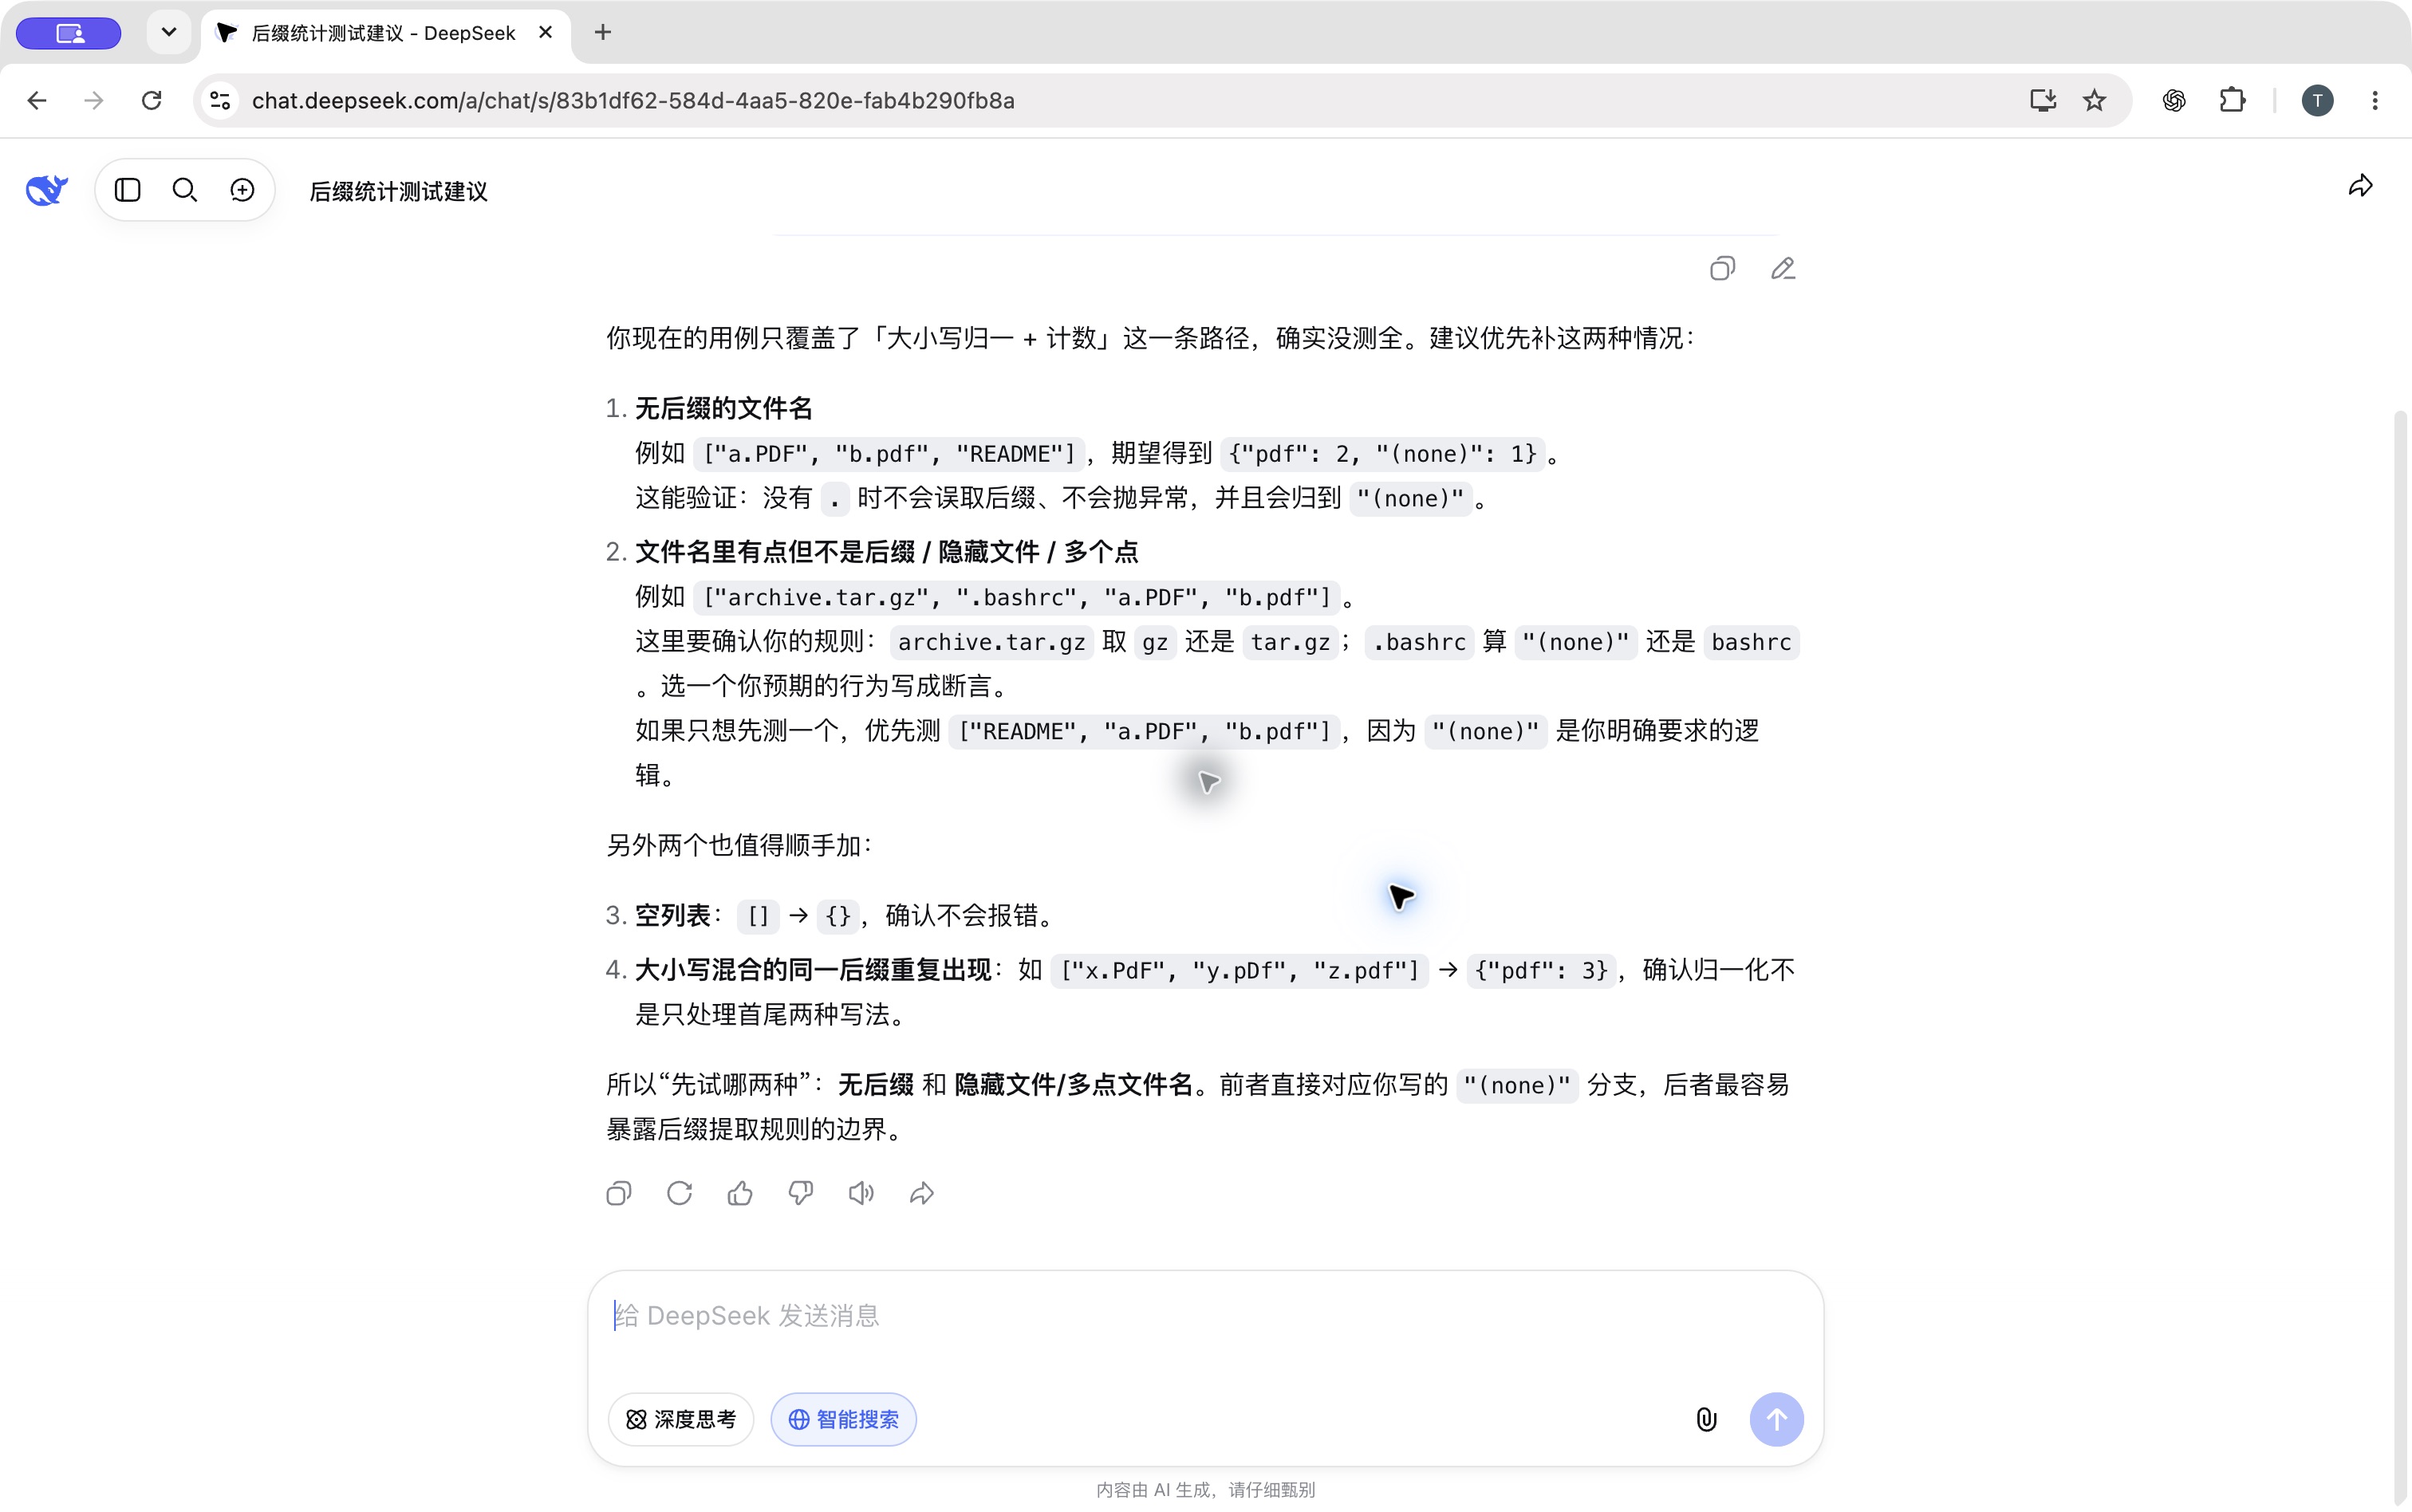
用 VS Code 取得实际状态,再向 AI 追问
当最后的输出不足以说明过程时,用调试器暂停程序,观察变量和调用栈。聊天助手没有看到你的暂停状态,除非你把代码、输入、暂停行、所选调用和变量值告诉它。以下复用 L7 的 factorial(3),不是新增一道实验题。
- 安装 Microsoft Python 与 Python Debugger 扩展,解压课堂 ZIP,用 File → Open Folder 打开整个项目文件夹。
- 打开
factorial.py,在 View → Command Palette 中运行Python: Select Interpreter,选择课程 Python 3.13。 - 在第4行行号左侧单击,出现红点即断点;程序会在该行执行前暂停。
- 打开 Run and Debug,选择随包配置
Classroom factorial(3),按 F5 或 Run → Start Debugging。普通 Run Python File 只是运行,不等于断点调试。 - 第一次暂停时
n=3,再 Continue 两次,依次到n=2、n=1。查看 Variables;在 Call Stack 选择外层调用,会看到它自己的n=3,不会让那次调用重新执行。
| 操作 | 常用键 | 观察什么 |
|---|---|---|
| Step Into | F11 | 进入当前行的函数调用 |
| Step Over | F10 | 执行当前行,通常不逐行进入被调用函数 |
| Step Out | Shift+F11 | 运行到当前调用返回 |
| Continue | F5 | 继续到断点或结束 |
内部断点仍可能让单步过程暂停。功能键可能需要 Fn,也可以点击工具栏或使用 Run 菜单。VS Code 官方调试说明。课堂实际调试截图使用本机 Python 3.14.7;同一程序的暂停行与 n=1/2/3 帧状态已另用课程 Python 3.13 核对。
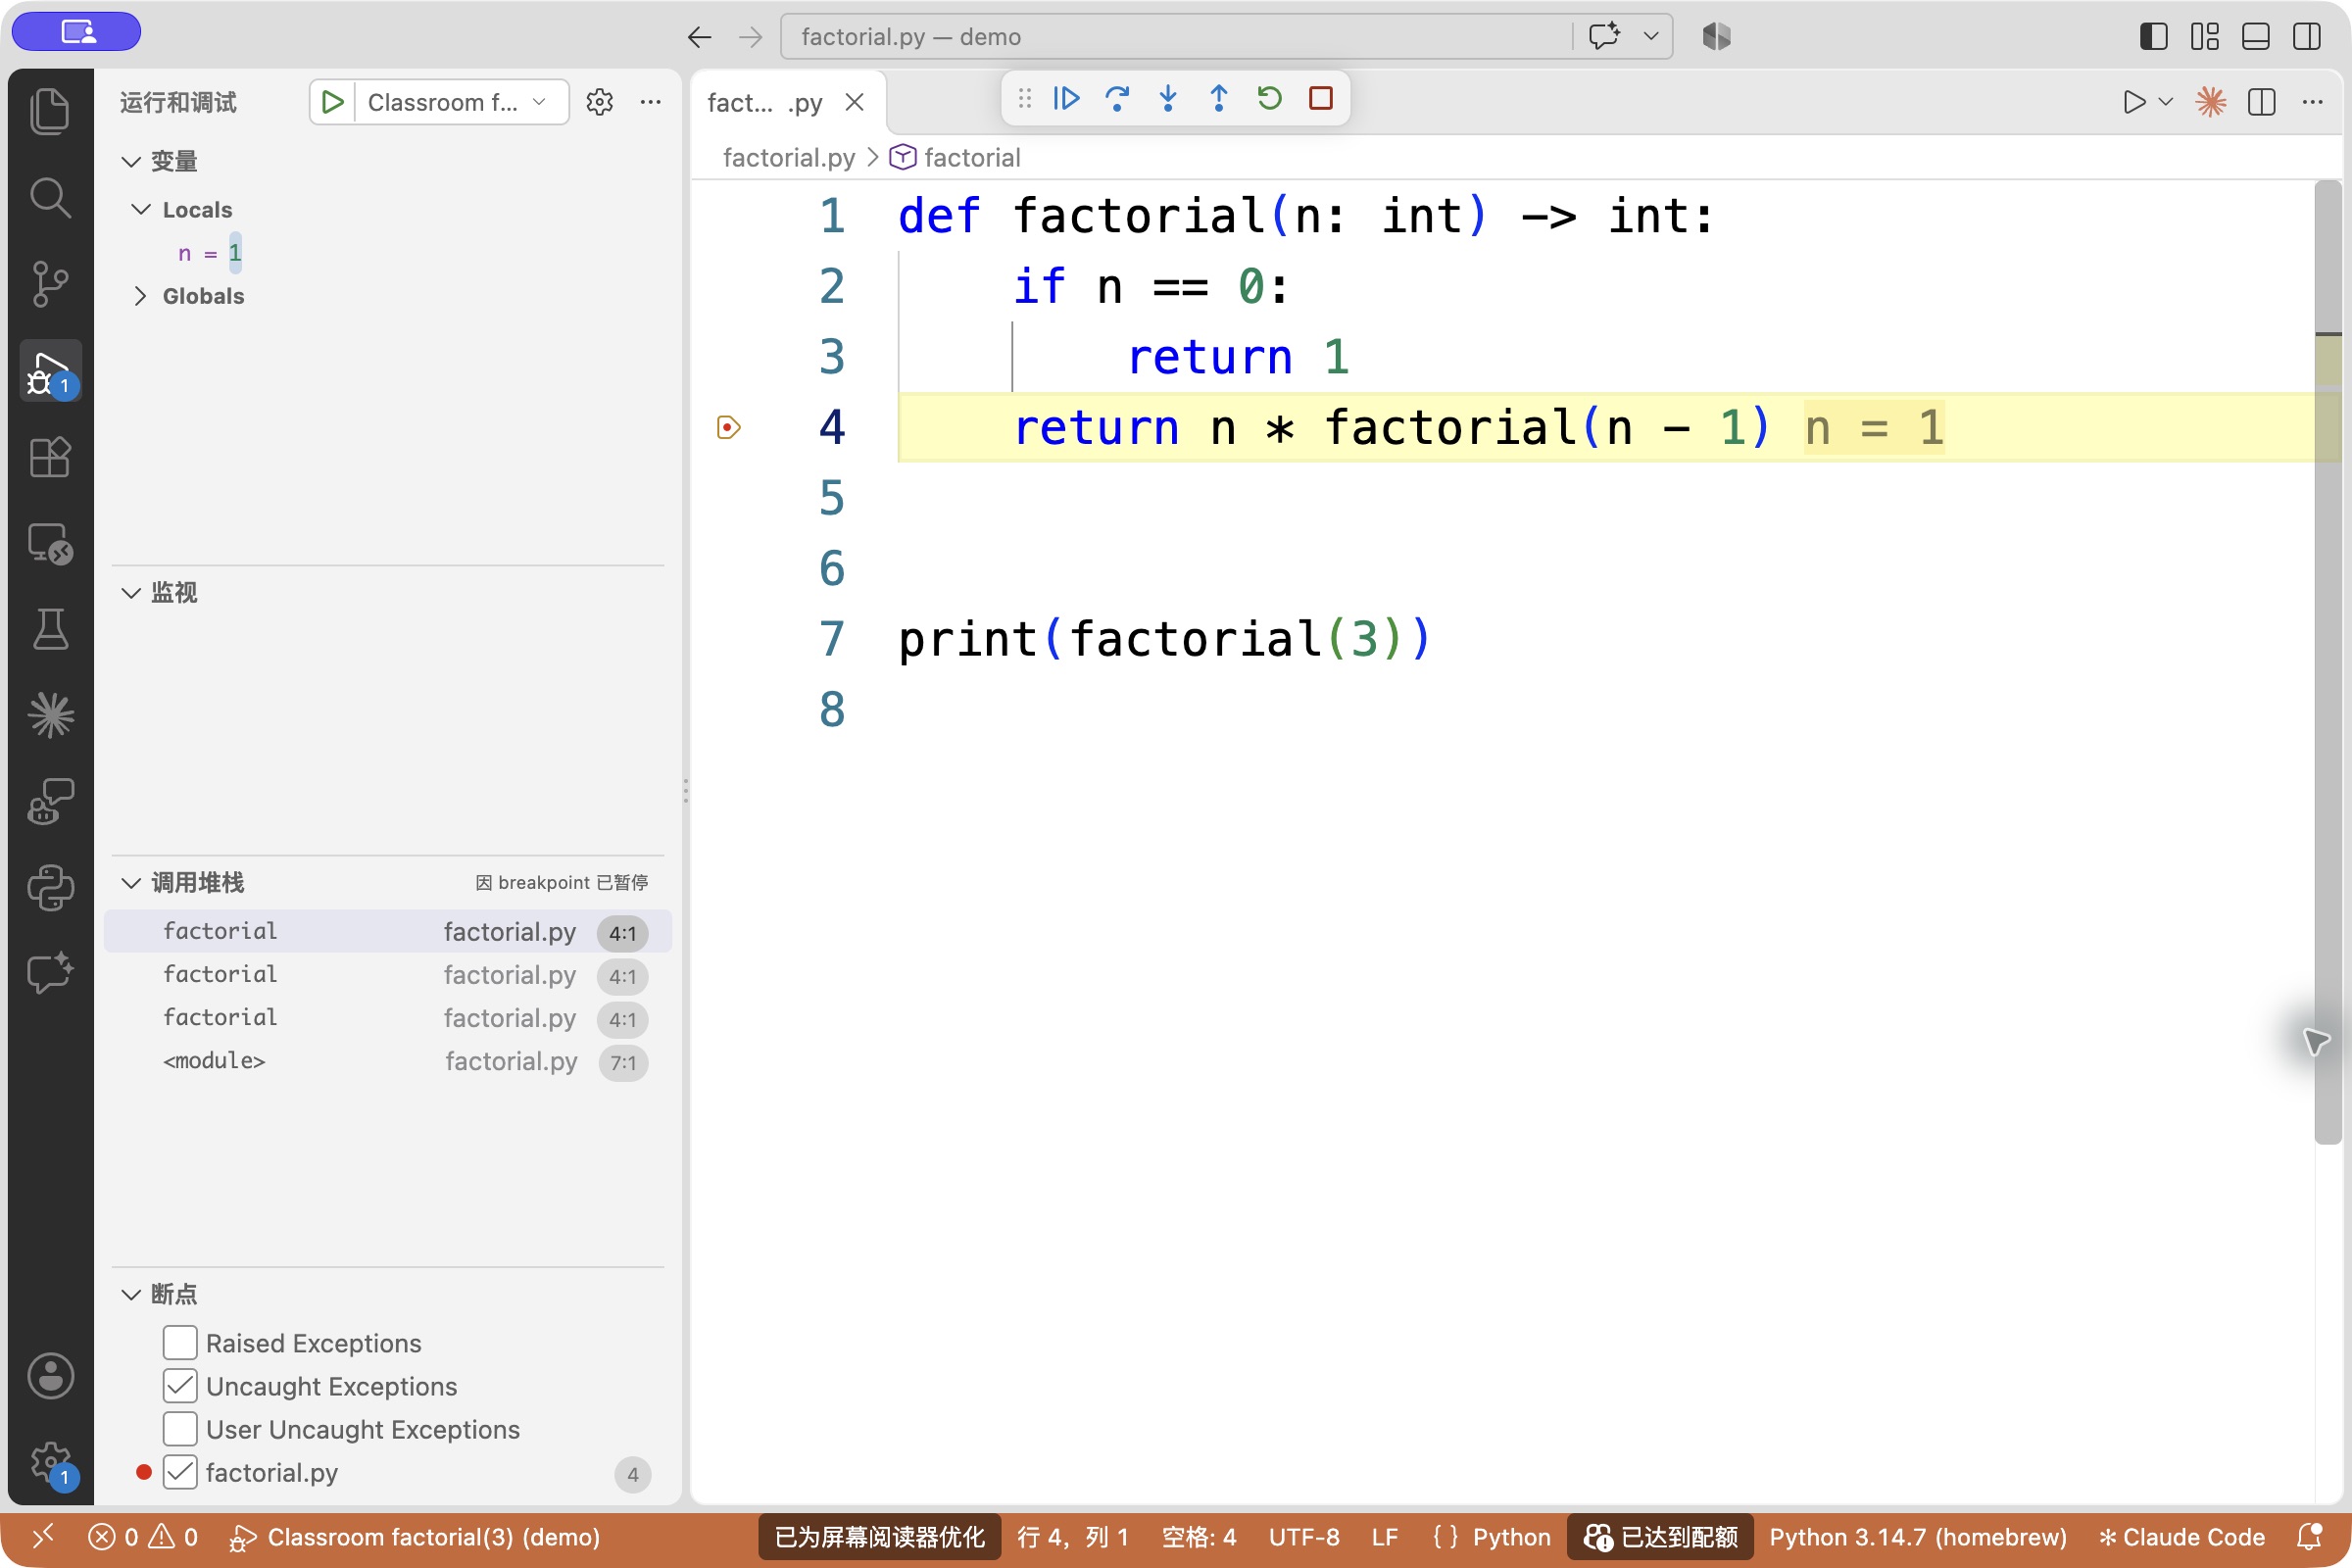
例如追问时可以提供:同一段 factorial.py、第4行、当前 factorial(1) 的 n=1,以及选中外层 factorial(3) 后看到的 n=3,再问两个数为何不同。代码和状态都应提供;这是后续请求的写法示例,不冒充另一段真实对话。
Ruff 可补充静态检查,调试器观察某次运行,独立测试核对选定输入的行为。第一部分到这里收束:提供上下文 → 局部求助 → 自己修改和调试 → 运行检查。
代码运行还需要 CPU 时间、内存和文件访问等系统支持。下面进入 Linux,先用视频认识幕后的操作系统,再用独立小例子练习终端。
第二部分:认识和使用 Linux
起源:Unix、GNU 与 Linux
Unix 于 1969 年起源于贝尔实验室。下面的真实照片展示 Thompson 与 Ritchie 使用 PDP-11 的早期七十年代场景,不能把照片年代直接当作 Unix 诞生日期。
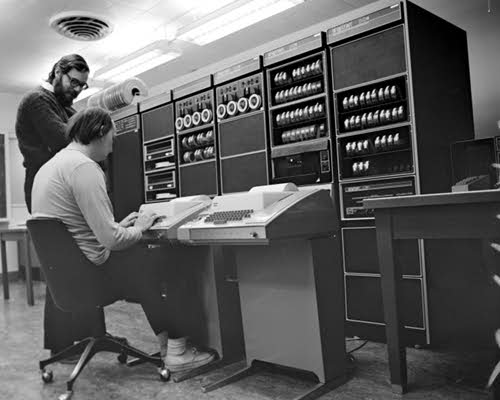
图片与历史说明:Bell Labs 原始档案。当时的系统也服务于文字处理等实际任务,终端让人与共享机器交互。
1983 年 GNU 项目宣布启动,目标是构建自由软件系统及工具。1991 年,赫尔辛基大学学生 Linus Torvalds 启动 Linux 内核项目,并在八月公开介绍。Linux 是独立编写的类 Unix 内核,不是把 Unix 源码直接改名。GNU 历史、Linux Foundation 记录。
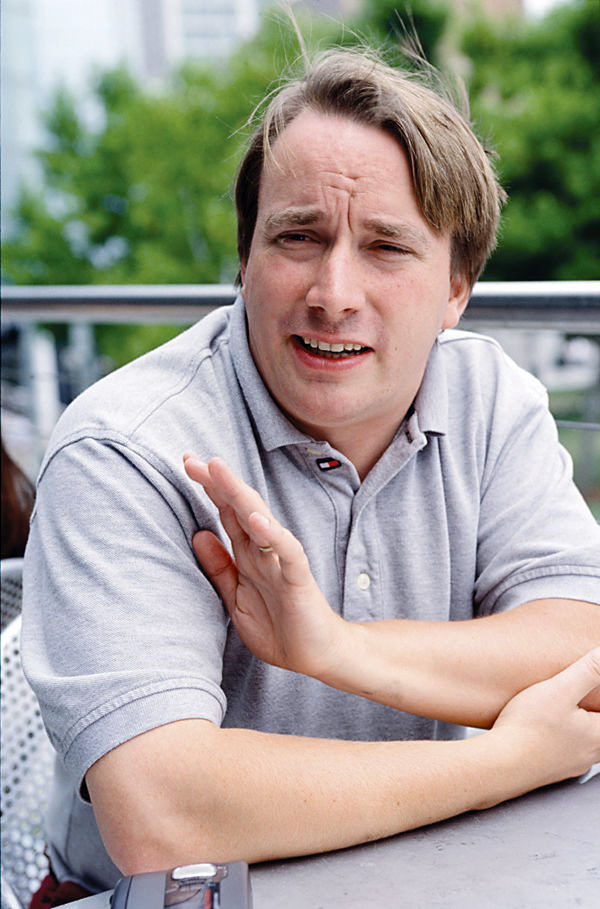
照片:kuvaaja / Linuxmag.com,2004,原图与 CC BY-SA 3.0 许可,未裁剪。这张照片不是 1991 年现场。

Linux 0.01 原始发行说明保留在 kernel.org:当时支持范围有限,还需要 shell、编译器、库等其他软件。由此可见,内核与一个完整可用系统的范围不同。开放源码使人们能够按许可阅读、修改与协作,并不意味着所有软件都没有许可条件。
内核管理哪些事情?
浏览器、音乐和 Python 可以同时运行。内核负责调度进程、管理内存与地址空间,并通过文件系统和驱动等组件管理文件、网络和设备访问。程序的 Python 语法和字典操作由解释器处理;读文件、创建进程和写终端等需要系统服务。Linux 内核说明。
这次从终端运行程序,可以按下面的过程理解:
终端显示交互
    ↓
Bash 解释命令并启动 Python
    ↓
Python 执行 hello.py
    ↓ 需要文件、进程与输出服务时
系统调用 → 内核 → 文件系统、驱动与硬件
这只是本次终端启动的路径,GUI 也能直接启动程序;shell 不是所有程序的必经层。多核可并行运行多个任务,单核也会调度任务,不把一个应用固定等同于一个核心。
内核、发行版、桌面、终端与 shell
| 名称 | 在本例中负责什么 |
|---|---|
| Linux 内核 | 进程、内存、设备与文件访问等系统服务 |
| Ubuntu 等发行版 | 将内核、工具、库、包管理与应用组合起来 |
| 桌面环境 | 图形窗口、启动器和文件管理器等交互 |
| 终端程序 | 显示文本输入输出,承载终端会话 |
| Bash 等 shell | 解释命令、重定向和管道,启动程序 |
| Python 解释器 | 执行 Python 源码 |
Ubuntu 是一种 Linux 发行版,Linux 内核是它的组成部分。 内核负责底层资源管理,发行版则把内核与 Bash、库、apt 等软件管理工具及应用组合、配置和维护为可使用的系统。日常说“用 Linux”常泛指使用这类系统;具体安装的可能是 Ubuntu、Debian GNU/Linux 或 Fedora Linux。图形桌面和应用选择取决于发行版、版本和安装方式,不是每种安装都包含同一套软件。Ubuntu 项目说明。
Linux 可以有图形桌面,服务器也可以不安装桌面。不同 Linux 内核系统不一定采用同样的 GNU 工具或用户空间,不能用一张桌面截图代表所有 Linux。
与 Windows、macOS 的实际区别
| 场景 | Windows 常见环境 | Linux 常见环境 |
|---|---|---|
| 路径 | C:\Users\Ana\project | /home/ana/project,单一 / 根目录下挂载文件系统 |
| 文件名大小写 | 常见默认不区分,可按目录配置 | 常见主目录区分,也取决于挂载文件系统 |
| shell | PowerShell、cmd 等 | Bash 等多种选择 |
| 软件工具 | 图形安装、商店与包管理工具 | 发行版包管理及其他安装方式 |
两边都有权限管理、图形界面和命令行工具,不能用“Windows 没有终端”或“Linux 只能黑框操作”解释区别。
WSL 2 在 Windows 的轻量虚拟机中运行真实 Linux 内核。Windows 的 C 盘通常在其中挂载为 /mnt/c;路径、文件位置和解释器要按实际环境核对。WSL 架构、文件系统与大小写说明。
macOS 使用 XNU 内核,许多 Unix 风格命令相似,但并非 Linux 内核。其 BSD 工具与 Linux 常用 GNU 工具的部分参数不同,查当前环境的帮助。Apple XNU 说明。
用几个独立小例子练习终端
先在自己的练习位置创建目录。用编辑器新建 hello.py,写入 print("hello") 并保存:
mkdir -p terminal-demo
cd terminal-demo
touch notes.txt
# 在编辑器中保存 hello.py 后运行
python3 hello.py
程序输出 hello。touch 只创建空文件或更新时间,不替你写代码,也不清空已有内容。pwd 查看当前位置,带空格的路径用引号,Tab 可以补全名字;python3 --version 确认解释器。
再放入一个简单的 helper.py,就可以查找和计数这两个 Python 文件:
find . -type f -name '*.py' | wc -l本例得到 2。find 从当前目录选择 .py 普通文件,管道传递路径文本,wc -l 统计换行。本例文件名没有换行,因而一条路径是一行;ls -l 的排版行不能直接当作文件数。
保存输出、再查找代码中的一行:
python3 hello.py > output.txt
cat output.txt
grep -n -F 'print(' hello.py
cat 输出 hello,grep 输出 1:print("hello")。-n 显示行号,-F 按字面文字匹配。> 会覆盖已有文件,>> 追加,普通 > 不自动保存标准错误。选项可查 find 手册与 grep 手册。
Ctrl+C 中断前台命令,向上键和 Ctrl+R 查历史,man、--help 或 shell 的 help 用于找帮助,分页器常用 q 退出。
Linux 部分回顾
- 内核管理 CPU、内存和设备等共享资源。
- 发行版组合内核、工具、库和应用。
- shell解释命令并启动程序。
到这里结束课堂主线。能解释系统各层,也能定位目录、运行 Python、查找文件或文字、保存输出和查帮助。
以下内容是课后补充与进一步阅读,不继续扩展课堂主线。
课后补充:完整参考实现与目录外壳
以下代码供课后独立阅读和复现,不需要在课堂 Linux 部分继续扩展项目。
完整参考实现
下面是教师提供的完整阅读材料,用于解释循环、独立运行和核对局部修正;完整展示教材代码,不表示 Level 1 允许学生让 AI 代写整题。其制作来源保持真实:函数由课程制作会话生成、保存并执行,初版使用 ext = parts[1],后来明确大小写规则并加入 .lower()。课堂学生操作只演示聊天请求这处局部帮助,再自己整合和运行。
def count_extensions(names: list[str]) -> dict[str, int]:
    counts = {}
    for name in names:
        parts = name.rsplit(".", 1)
        ext = "(none)"
        if len(parts) == 2 and parts[0] and parts[1]:
            ext = parts[1].lower()
        counts[ext] = counts.get(ext, 0) + 1
    return counts

names = ["L01.PDF", "L02.pdf", "README", ".env", "archive.tar.gz"]
before = names.copy()
print(count_extensions(names))
print(names == before)
真实结果是 {'pdf': 2, '(none)': 2, 'gz': 1} 和 True。rsplit(".", 1) 从右侧最多拆一次;检查两部分均非空后再取后缀。lower() 返回新字符串,只绑定局部变量 ext,不改写文件名列表。
独立检查与最小修改
先按约定确定预期,例如 ['L01.PDF', 'L02.pdf'] 应得到 {'pdf': 2}。第一版区分大小写时,反馈应包含输入、预期、实际与规则依据,而不只是“错了,再改”。如果发生异常,保留完整错误信息。
检查至少覆盖空列表、大小写、隐藏文件、多个点、重复名字、输入不变和独立返回字典。下面的短程序可独立执行,不依赖先前代码块:
def count_extensions(names: list[str]) -> dict[str, int]:
    counts = {}
    for name in names:
        parts = name.rsplit(".", 1)
        ext = "(none)"
        if len(parts) == 2 and parts[0] and parts[1]:
            ext = parts[1].lower()
        counts[ext] = counts.get(ext, 0) + 1
    return counts

cases = [
    ([], {}),
    (["L01.PDF", "L02.pdf"], {"pdf": 2}),
    (["README", ".env", "notes."], {"(none)": 3}),
    (["archive.tar.gz", ".config.json"], {"gz": 1, "json": 1}),
]
for names, expected in cases:
    before = names.copy()
    assert count_extensions(names) == expected
    assert names == before
print("4 cases and input preservation: PASS")
修正后运行新反例和已有检查,再查看 diff。若规则未变,不能仅为通过检查而把预期改成候选的错误结果;测试本身也可能写错,仍应回到任务判断。保存可工作的 Git 版本,声明真实的工具、生成范围、人工修改和验证。不要复制一个没有实际执行过的使用声明。
目录读取外壳(本讲不展开)
这部分是课后补充,不属于本讲 Linux 部分的课堂任务。目录读取与命令行入口由教师提供,L12 再系统学习。下面是供本机运行的完整外壳;将上面的函数定义与它保存为同一个 inventory.py,不要在网页运行器里访问个人磁盘。
from pathlib import Path
import sys

# Add count_extensions from the independently runnable example above.

def main() -> None:
    """Instructor-provided file and command-line adapter; see Lecture 12."""
    folder = Path(sys.argv[1]) if len(sys.argv) > 1 else Path("sample-files")
    names = [item.name for item in folder.rglob("*") if item.is_file()]
    counts = count_extensions(names)
    for ext in sorted(counts):
        print(f"{ext}: {counts[ext]}")


if __name__ == "__main__":
    main()
在专门的课堂目录运行:
python3 check_inventory.py
python3 inventory.py sample-files
python3 inventory.py sample-files > report.out
cat report.out
sample-files 是相对于当前工作目录的路径,不会自动相对于脚本位置。报告写在被统计目录之外,避免下次把报告本身也计入。工具只读演示目录,不改名、不删除文件。示例项目位于课程源码 slides/l08/demo/,与计分实验分开。
额外反例:不报错仍可能不符合约定
这是原有的教师教学候选,不是前面 DeepSeek 的实际首次修复。
def suffix(name):
    return name.split(".")[-1].lower()

print(suffix("README"))
print(suffix("archive.tar.gz"))
它对 README 返回 readme,仍不符合无后缀规则。
完整后缀处理参考
def suffix(name):
    parts = name.rsplit(".", 1)
    if len(parts) == 2 and parts[0] and parts[1]:
        return parts[1].lower()
    return "(none)"

for name in ["L01.PDF", "README", ".env", "archive.tar.gz"]:
    print(name, suffix(name))
回归检查还应覆盖空列表、重复名字、输入不变与返回字典相互独立。
进一步阅读一、候选代码与验证依据
L07 检查了递归的任务、基准情形、终止条件和返回值。相同的方法也适用于同学、网络资料或 AI 提供的代码。
一个程序通过了样例,说明它在这组输入上得到了预期结果。输入范围、边界情况、状态变化和数据规模,仍需要分别检查。解释流畅、代码简短,都不能补充尚未进行的验证。
下面的错误程序是为教学构造的候选实现,不是真实模型回答的逐字记录。它们用于说明检查方法,不代表某个模型必然产生这些错误。
生成文本与执行代码
这里的 token 是模型处理文本的单位,可能对应一个词、词的一部分或标点,并不固定等于一个字符。大语言模型根据上下文生成后续 token。生成代码和解释,并不自动产生执行结果。
在 Level 2,coding agent 还可以操作项目、运行程序或执行测试。本周 Level 1 由学生本人操作和运行。无论谁执行,都需要区分三种记录:
| 记录 | 能说明什么 | 不能由此推出什么 |
|---|---|---|
| 一段候选代码及其解释 | 提供了某种实现和理由 | 程序已经运行,或实现符合全部需求 |
| 一次运行的输入和输出 | 这次运行的实际行为 | 所有输入都正确 |
| 一组测试及其结果 | 这些检查是否通过 | 测试覆盖了所有缺陷 |
采纳实现时,还要把这些证据与需求、代码逻辑和运行环境一起核对。AI 可以帮助分析和测试;提交者仍须理解采用的实现。
三类常见检查
接口是否存在。 字符串没有 reverse() 方法:
s = "hello"
print(s.reverse())
运行会触发 AttributeError。应查阅对应对象的文档,确认方法名称、参数、返回值和副作用。不能因为列表有 reverse(),就假定字符串也有同名方法。
下面的切片产生反转后的新字符串,原字符串不变:
s = "hello"
print(s[::-1])
print(s)
行为与边界是否明确。 这段平均值程序对非空列表正常,对空列表会除以零:
def average(nums: list[float]) -> float:
    return sum(nums) / len(nums)

print(average([1, 2, 3]))
print(average([]))
若规格只接受非空输入,空列表不在输入范围内。若任务需要接受空列表,就必须另外约定其行为。不能先看实现怎么处理,再把实现的行为当作需求。
运行环境是否一致。 旧语法、库版本和接口签名需要核对。下面是 Python 2 的写法,在本课程 Python 3.13 中不能运行:
# Python 2 syntax, not valid in the course's Python 3 environment.
print "hello"
这三类检查之外,还要审查效率和可读性。程序不报错,不等于它适合任务的数据规模,也不等于它易于维护。
进一步阅读二、函数规格与提问
签名说明接口,行为约定说明任务
“合并两个列表,排好序”还有很多未决定的细节:两个输入本来是否有序,重复项是否保留,是否可以修改输入,返回什么类型。
函数签名可以说明参数和返回类型:
def merge_sorted(a: list[int], b: list[int]) -> list[int]:
    """Merge two ascending integer lists into a new ascending list.
    Keep duplicates. Do not modify either input.
    """
    ...
排序、保留重复项和输入不变来自说明文字,不能从 list[int] 推出。这个片段只是接口规格,... 不是已经完成的实现。
Python 不会自动按照类型提示检查实参。下面的调用仍执行字符串拼接:
def twice(x: int) -> int:
    return x + x

print(twice("ab"))
类型检查器和编辑器可以利用注解提示问题,但注解本身不会自动保证行为。可执行的检查还需要测试或其他专门机制。
状态变化也是需求
预测下面两次打印的结果:
def without_two(items):
    result = items
    result.remove(2)
    return result

values = [1, 2, 3, 2]
print(without_two(values))
print(values)两个名字指向同一个列表;remove(2) 只删除首个匹配项。因此两行都是 [1, 3, 2]。
若任务要求“删除全部匹配项,返回新列表,不修改输入”,可以用已经学过的列表推导:
def remove_all(items: list[int], value: int) -> list[int]:
    return [x for x in items if x != value]

values = [1, 2, 3, 2]
print(remove_all(values, 2))
print(values)
检查输入是否改变,可以在调用前保存副本:
def remove_all(items: list[int], value: int) -> list[int]:
    return [x for x in items if x != value]

values = [1, 2, 3, 2]
before = values.copy()
result = remove_all(values, 2)
print(result == [1, 3])
print(values == before)
上下文、约束和例子
一份便于检查的提问至少应包含:
- 函数任务、签名和输入范围;
- 返回值、顺序、重复项及输入是否改变;
- 使用的 Python 版本、允许的库和已掌握的语法;
- 普通与边界输入的预期结果;
- 数据规模和需要满足的效率要求。
例如,已经自行写好词频统计主体,但局部字符串处理不符合规格时,可以这样询问:
I wrote the word-counting loop. This is the current local preprocessing:
word = token.lower()
The rule says to strip only . , ! ? ; : from both ends of each word.
Why does "cat." remain a different key from "cat"?
Explain and suggest only the change to this preprocessing line.
Do not write the full count_words function; I will integrate and test it.
这些约定仍要按任务检查,不能把一份模板用于所有程序。列出空输入有助于明确要求,但不能据此保证模型不再遗漏边界。
小任务与可复现反馈
L07 用较小子问题组织实现。本周先由自己完成任务分析和主体代码;遇到困难时,缩小到一个具体条件、语句或局部代码段求助。把整题拆成连续请求而让 AI 最终代写全部实现,仍不符合 Level 1 的完整代码边界。
反馈失败时,保留以下信息:
Function: max_gap
Input: [7]
Expected result: 0, as specified for fewer than two elements
Actual result: ValueError from max([])
Runtime: Python 3.13
Relevant code: the construction of gaps and the final max(gaps)
不要只写“错了,再改”。AI 对原因的解释也是待核对的候选分析,不能替代反例和运行记录。
进一步阅读三、可读性与 PEP 8
先读出任务,再改写结构
下面的程序能够运行,但函数名、参数名和嵌套结构增加了阅读负担:
def f(l, D):
    R = []
    for i in range(0, len(l)):
        if l[i] in D:
            if D[l[i]] > 0:
                R.append(l[i])
    return R

print(f(["a", "b", "c"], {"a": 1, "b": 0, "c": 5}))
先说清行为:按输入顺序保留字典中计数为正的键。输入键有重复时,重复项也保留。再改名、整理条件:
def filter_positive(
    keys: list[str], counts: dict[str, int]
) -> list[str]:
    """Keep present keys with positive counts, in input order."""
    return [k for k in keys if counts.get(k, 0) > 0]

print(filter_positive(["a", "b", "c"], {"a": 1, "b": 0, "c": 5}))
print(filter_positive(["a", "x", "a"], {"a": 2}))
没有类型提示或文档字符串,不直接等于违反 PEP 8;本例补上它们,是为了明确接口和任务。重构还需要核对改写前后的行为。
常见风格检查
PEP 8 是 Python 代码风格指南。它强调可读性与一致性,不证明程序的功能正确。
| 项目 | 常见约定 |
|---|---|
| 缩进 | 每级 4 个空格;不要混用 Tab 和空格 |
| 行长 | 通常代码 79 字符、注释和文档字符串 72 字符;团队可约定其他长度 |
| 空行 | 顶层函数和类定义之间两空行;类内方法之间一空行 |
| 函数、变量 | snake_case,如 student_count |
| 常量 | UPPER_CASE,如 MAX_RETRY |
| 类 | CapWords,如 BankAccount;具体语法在 L09 学习 |
| 模块、包 | 通常为简短小写名称,如 utils、mypackage |
| 内部使用 | 前导下划线,如 _helper;不是权限检查 |
| 易混淆名字 | 避免单字母 l、O、I |
| 内置名 | 避免用 list、str、sum、type 等覆盖需要使用的内置接口 |
续行可在括号内对齐,或使用悬挂缩进:
result = some_function(first_argument,
                       second_argument)

result = some_function(
    first_argument,
    second_argument,
)
这是排版示例,不是完整可运行程序。长表达式在运算符之前或之后换行都可以,局部应保持一致;PEP 8 建议新代码在运算符之前换行:
income = (gross_wages
          + taxable_interest
          - ira_deduction)
括号内侧不加多余空格;逗号、冒号前不加空格;赋值和比较运算符两侧留空格。运算优先级不同的表达式,可以依指南适当调整空格来体现分组。风格差异不改变运算符优先级,也不自动构成语法错误。
# Recommended layout.
spam(ham[1], {eggs: 2})
if x == 4:
    print(x, y)

# Legal in suitable contexts, but not the recommended layout.
spam( ham[ 1 ], { eggs: 2 } )
无注解的默认参数和调用中的关键字实参,等号两侧不加空格;带注解的默认参数则加空格:
def f(x, y=2):
    ...


def g(x: int, y: int = 2) -> int:
    ...
格式化、静态检查与行为测试
三种工作不要混为一谈:
| 工作 | 示例 | 用途 |
|---|---|---|
| 格式化 | ruff format file.py,或使用 Black | 调整空格、换行等排版 |
| 静态检查 | ruff check file.py | 按启用的规则发现未使用导入、未定义名字等问题 |
| 行为测试 | 运行自己的输入并比较预期结果 | 检查具体需求 |
Ruff 的配置决定启用哪些规则。默认检查不是“全部 PEP 8”;没有报告,也不表示没有逻辑错误。ruff format 不会自动决定空列表求平均应该返回什么。
python3 -m pip install ruff
ruff check file.py
ruff format --check file.py     # check without rewriting
在 VS Code 中也可以使用 Ruff 扩展。若 pip 提示环境由系统管理,不要改用管理员权限强制安装;选择课程安装的 Python,或使用编辑器扩展。虚拟环境的系统介绍在 L10。Black 是另一种格式化选择,不要求与 Ruff 同时安装。
进一步阅读四、测试、反例与调试
测试预期来自规格
为 max_gap 约定:输入为整数列表,返回排序后相邻元素的最大差;少于两个元素时返回 0;不修改输入。
| 输入 | 预期 | 检查内容 |
|---|---|---|
[3, 9, 1, 15] | 6 | 普通未排序输入 |
[] | 0 | 空输入 |
[7] | 0 | 单元素 |
[2, 2, 2] | 0 | 重复项 |
[-3, -1, -10] | 7 | 负数 |
候选程序遗漏短输入:
def max_gap(nums: list[int]) -> int:
    ordered = sorted(nums)
    gaps = [ordered[i + 1] - ordered[i]
            for i in range(len(ordered) - 1)]
    return max(gaps)

print(max_gap([7]))
[7] 使 gaps 为空,max([]) 触发 ValueError。修正后,先检查已知反例,再检查原本成功的输入:
def max_gap(nums: list[int]) -> int:
    if len(nums) < 2:
        return 0
    ordered = sorted(nums)
    gaps = [ordered[i + 1] - ordered[i]
            for i in range(len(ordered) - 1)]
    return max(gaps)

for nums, expected in [([3, 9, 1, 15], 6), ([7], 0), ([], 0)]:
    before = nums.copy()
    got = max_gap(nums)
    print(got == expected, nums == before)
这是回归检查。有限测试可以暴露错误,通常不能证明函数对所有输入正确。还要阅读循环范围、边界判断和输入变化。
常用检查包括空输入、一个元素、重复项、零与负数、数据规模、结果顺序和副作用。错误类型是否需要处理,取决于接口约定;一个只接受整数列表的函数,不必未经要求就接受任意对象。
阅读回溯
| 异常 | 常见含义或例子 |
|---|---|
SyntaxError | 语法不合法,如缺少冒号 |
IndentationError | 缩进层级不合法 |
NameError | 使用尚未定义的名字 |
TypeError | 运算或调用不接受当前类型/参数形式 |
ValueError | 类型可接受,但值不满足接口要求,如 int("abc") |
IndexError | 序列下标超出范围 |
KeyError | 字典中没有被直接索引的键 |
ZeroDivisionError | 除数为零 |
AttributeError | 对象没有访问的属性或方法 |
RecursionError | 当前执行超过解释器的递归深度限制 |
回溯包含调用位置与失败语句,最后一行通常给出异常类型和信息。现代 Python 还可能显示源码、波浪线和箭头;不能固定说“倒数第二行就是错误行”。递归深度异常既可能来自错误递推,也可能来自合法但过深的输入。L11 再讲异常处理语法。
从反例观察中间状态
下面的候选返回最长连续 1 的长度,输入只含 0 和 1,空列表应返回 0:
def longest_run(bits: list[int]) -> int:
    current = 0
    best = 0
    for bit in bits:
        if bit == 1:
            current += 1
        else:
            best = max(best, current)
            current = 0
    return best

print(longest_run([1, 1, 0]))
print(longest_run([1, 1, 0, 1, 1, 1]))
第一例得到 2,第二例也得到 2,但预期为 3。返回前 best=2、current=3:末尾连续段没有遇到 0,未更新 best。
可以暂时打印这两个变量,也可以在 VS Code 的返回语句前设断点:
- 启用 Python 与 Python Debugger 扩展,选择课程解释器;
- 点击语句左侧设置断点,通过“运行和调试”启动;
- 执行到该位置时,程序在语句执行前暂停;
- 查看当前选中调用帧的变量,或把
best、current加入 Watch。
| 动作 | 常见快捷键 | 作用 |
|---|---|---|
| Continue | F5 | 继续到下一断点或结束 |
| Step Over | F10 | 执行当前行,不进入被调用函数 |
| Step Into | F11 | 进入当前行调用的函数 |
| Step Out | Shift+F11 | 执行完当前函数,回到调用者 |
系统、键盘或自定义设置可能改变快捷键,部分键盘需同时按 Fn;工具栏动作名称也可使用。Watch 在暂停时按当前上下文求值,不是程序运行期间的连续监视器。
按本题约定,把最后一段与已记录最大值一起比较即可:
def longest_run(bits: list[int]) -> int:
    current = 0
    best = 0
    for bit in bits:
        if bit == 1:
            current += 1
        else:
            best = max(best, current)
            current = 0
    return max(best, current)

for bits in [[], [0], [1], [1, 1, 0], [1, 1, 0, 1, 1, 1]]:
    print(bits, longest_run(bits))
递归调用帧
L07 的 factorial(3) 进入 factorial(1) 时,调用栈中有参数为 1、2、3 的三个调用。选中不同帧,看到的是各自局部的 n。内层 n=1 不会把外层的 n=3 改成 1。
print 适合少量中间值和批量记录;调试器适合暂停、单步和切换调用帧。两者均可使用,不以一种工具替代全部调试方法。
进一步阅读五、效率与数据规模
这个去重实现保留首次出现顺序:
def dedup(items: list[int]) -> list[int]:
    result = []
    for x in items:
        if x not in result:
            result.append(x)
    return result

print(dedup([3, 1, 3, 5, 1]))
阅读代码就能注意到:每个输入元素都会在逐渐变长的列表中查找。可以进一步把查找写成显式循环,统计检查了多少个已有元素:
def dedup_counted(items: list[int]) -> tuple[list[int], int]:
    result = []
    comparisons = 0
    for x in items:
        found = False
        for old in result:
            comparisons += 1
            if old == x:
                found = True
                break
        if not found:
            result.append(x)
    return result, comparisons

for n in [10, 100, 1000]:
    result, checks = dedup_counted(list(range(n)) * 2)
    print(n, checks)
这组特定输入中,n 个不同元素依次出现两轮,显式比较数为 n²。这里没有测 CPython 的机器指令数,也没有证明所有数据分布都恰好需要 n² 次检查。
L06 的集合可保存已经见过的整数,列表继续保存结果顺序:
def dedup(items: list[int]) -> list[int]:
    seen = set()
    result = []
    for x in items:
        if x not in seen:
            seen.add(x)
            result.append(x)
    return result

for items in [[], [3, 1, 3, 5, 1], [-1, 0, -1]]:
    before = items.copy()
    print(dedup(items), items == before)
集合查找具有较低的平均代价,不保证每次查找固定一步。本例输入为可哈希整数;不能未经检查就用于列表元素等不可哈希对象。
比较速度时应使用相同输入、环境和测量方法,并核对结果等价。秒数受硬件、解释器和其他任务影响,不能把一次计时的倍率当作通用结论。L11 再系统分析复杂度、时间和空间。
进一步阅读六、审查活动与使用声明
四份候选实现
本讲已经检查了四类候选:
- 不存在的
items.remove_all(value):用文档和执行确认接口; max_gap:用短输入暴露缺失边界;dedup:分析反复列表查找,再核对操作数和规模;f(l,D):读出行为,改名和整理结构,检查等价性。
不要把每份候选都预设为“恰好一处错误”。也不要为了报告数量,把输入约定之外的行为自动认定为缺陷。
IPv4 任务的检查约定
Lab08 使用 is_valid_ipv4(s: str) -> bool。本活动的输入为字符串,并采用以下严格点分十进制约定:
- 恰好四段,以英文句点
.分隔; - 每段只含 ASCII 数字
0到9,数值为 0–255; - 单个
0合法,其他形式不允许前导零; - 不接受空段、正负号、前后或内部空白。
先独立写测试,再查看候选。合法例子可以包括 0.0.0.0、192.168.1.1、255.255.255.255;非法例子要覆盖段数、范围、前导零和字符范围。这里不提供实验的完整正确实现。
文档和实跑可以帮助发现:int() 接受的字符串范围比这份规格更宽;isdigit() 也不只接受 ASCII 数字。
for s in ["01", "+1", " 1", "1"]:
    print(repr(s), int(s))

for s in ["1", "1", "²"]:
    print(repr(s), s.isdigit())
ASCII 限定是本活动明确规定的要求;Python ipaddress 文档说明四段和前导零规则,但该页面没有逐字给出这条字符范围限定。检查陌生接口时要区分文档原句、实测行为与本题约定。
分工与安全
| 环节 | 应保留的工作 |
|---|---|
| 理解和拆解 | 明确目标,决定输入、结果和接口 |
| 实现 | 本人负责主体,AI 可通过聊天建议局部代码 |
| 审查 | 读懂关键状态、未知接口和副作用 |
| 测试 | 自己依据规格设计检查,工具可以补充 |
| 修正 | 核对反例,保留原候选与修改范围 |
| 采纳 | 能说明依据,并对提交内容负责 |
先明确需求,再逐步实现和验证。不要使用无法解释的写法;先查文档和运行环境。先实现功能,再根据数据规模决定是否需要优化,不以“不要提前优化”为由忽略已知规模问题。
向外部工具提供材料前,移除个人信息、会话令牌、密码和密钥。未经审查,不运行包含不理解的文件操作、安装或网络请求的代码。错误示例只在自己可控制的小规模环境中运行。
AI 使用声明
本周 Level 1 仅允许聊天式局部代码帮助与调试,不能让 AI 直接生成整题完整解或由 coding agent 操作项目。仍须说明工具、局部生成或修改范围和本人实际验证。以下是填写格式示例,不是真实使用日志:
AI 使用声明:
工具与模型:填写实际使用的名称;型号不清楚则注明。
生成或修改范围:例如,后缀归一的 ext = parts[1].lower() 一行建议。
人工修改:指出修改的函数、条件或代码段;没有修改也据实说明。
验证:列出实际运行的输入、预期和结果,并说明是否检查输入不变。
未使用 AI 的部分:说明自行完成的范围。
“AI 说程序正确”不是运行记录。工具不可用而使用教师提供的候选时,也要据实填写来源,不能编造聊天记录。完全未使用 AI,就明确写未使用。
个人作业 1 的普通与相邻杆汉诺塔仍按 Level 0 执行,占总成绩 5%,截止见个人作业 1 提交页。本周进入 Level 1 不改变该作业要求。不能把个人作业代码交给 AI 生成或改写;本讲演示使用课堂阶乘等独立例子。
进一步阅读七、往年练习与参考规范
导入、注释和其他排版
保留以下查阅项目:
- import 放在模块文档字符串之后,按标准库、第三方、本项目分组,组间空行;尽量避免通配导入覆盖不明名字。
- 优先使用括号内隐式续行;避免行末空白、多条语句挤在同一行。
- 单元素元组需要逗号;是否保留多行结构尾逗号按指南与项目约定。
- 注释说明原因,更新代码时同步更新注释;文档字符串说明用途、参数和结果。
- Python 3 默认源码编码为 UTF-8;引号选择保持一致,不把一种引号误称为唯一正确形式。
- 类、继承、公共接口、异常命名等参考项,随后续讲次再展开,不要求现在掌握其语法。
导入分组示例仅展示风格,第三方与本项目模块不作为已安装依赖:
import os
import sys

import numpy as np

from mypackage import helper
完整条目见 PEP 8。Python 之禅可在本机或网页运行:
import this它由 Tim Peters 撰写,强调可读性、明确性等设计取舍,不是逐行判分的正确性规则。
闰年:等价写法与边界
公历正整数年份,能被 4 整除且不能被 100 整除,或能被 400 整除,为闰年。以下三种结构对应相同规则:
def leap_separate(year: int) -> bool:
    if year % 4 == 0 and year % 100 != 0:
        return True
    if year % 400 == 0:
        return True
    return False


def leap_branches(year: int) -> bool:
    if year % 4 == 0 and year % 100 != 0:
        return True
    elif year % 400 == 0:
        return True
    else:
        return False


def leap_boolean(year: int) -> bool:
    return (year % 4 == 0 and year % 100 != 0
            or year % 400 == 0)

for year in [1900, 2000, 2024, 2100]:
    print(year, leap_separate(year), leap_branches(year), leap_boolean(year))
素数:输入范围与试除界限
素数是大于 1、只有 1 与自身两个正因数的整数。往年两个版本都遗漏 n<2;不能用几个正整数样例掩盖这个问题。
def prime_slow(n: int) -> bool:
    if n < 2:
        return False
    for divisor in range(2, n):
        if n % divisor == 0:
            return False
    return True


def prime_fast(n: int) -> bool:
    if n < 2:
        return False
    divisor = 2
    while divisor * divisor <= n:
        if n % divisor == 0:
            return False
        divisor += 1
    return True

for n in [-1, 0, 1, 2, 3, 4, 9, 97]:
    print(n, prime_slow(n), prime_fast(n))
若合数 n 有因数 d 大于平方根,配对因数 n//d 就小于平方根,所以不必试到 n−1。平方边界要包含等号。这里用整数乘法,避免以浮点数近似决定界限。
数位平方和与快乐数
非负整数的每位平方求和,可以用循环、递归或字符串遍历:
def squares_loop(n: int) -> int:
    total = 0
    while n > 0:
        total += (n % 10) ** 2
        n //= 10
    return total


def squares_recursive(n: int) -> int:
    if n < 10:
        return n * n
    return (n % 10) ** 2 + squares_recursive(n // 10)


def squares_text(n: int) -> int:
    total = 0
    for ch in str(n):
        total += int(ch) ** 2
    return total

for n in [0, 2, 9, 19, 29]:
    print(n, squares_loop(n), squares_recursive(n), squares_text(n))
旧递归基准返回 n,对 2 得到 2 而不是 4;19 的样例恰好没有暴露这项错误。三种方法都需核对最小输入,递归还受深度限制。
对正整数反复应用数位平方和,若最终到 1,称为快乐数;若出现已访问值,后续将重复同一过程。
def sum_digit_squares(n: int) -> int:
    total = 0
    while n > 0:
        total += (n % 10) ** 2
        n //= 10
    return total


def is_happy(n: int) -> bool:
    seen = set()
    while n != 1:
        if n in seen:
            return False
        seen.add(n)
        n = sum_digit_squares(n)
    return True

print(is_happy(19))
print(is_happy(2))
已访问集合表示经过的状态,不表示状态的次数;这里按任务只需判断是否重复。输入 0 不属于本定义的正整数范围。
连续的 1 与连续递增段
往年双 while 写法也能计算最长连续 1。虽然有嵌套循环,外层下标会越过已经扫描的连续段,不能只看外观就断言是平方工作量。
def longest_run(bits: list[int]) -> int:
    best = 0
    i = 0
    while i < len(bits):
        if bits[i] == 1:
            j = i
            while j < len(bits) and bits[j] == 1:
                j += 1
            best = max(best, j - i)
            i = j
        else:
            i += 1
    return best

for bits in [[], [0], [1], [1, 1, 0, 1, 1, 1]]:
    print(bits, longest_run(bits))
连续严格递增段必须使用相邻元素,相等时结束当前段;不能跳过中间元素拼成任意递增子序列:
def longest_increasing_run(nums: list[int]) -> int:
    if not nums:
        return 0
    current = 1
    best = 1
    for i in range(1, len(nums)):
        if nums[i] > nums[i - 1]:
            current += 1
        else:
            current = 1
        best = max(best, current)
    return best

for nums in [[], [1, 3, 5, 4, 7], [2, 2, 2], [1]]:
    print(nums, longest_increasing_run(nums))
字母重排与重数
本例输入为小写 ASCII 字符串。两串每个字符的出现次数相同,才互为字母重排。字典计数与排序均可实现:
def char_counts(s: str) -> dict[str, int]:
    counts = {}
    for ch in s:
        counts[ch] = counts.get(ch, 0) + 1
    return counts


def anagram_counts(s: str, t: str) -> bool:
    return char_counts(s) == char_counts(t)


def anagram_sorted(s: str, t: str) -> bool:
    return sorted(s) == sorted(t)

for s, t in [("anagram", "nagaram"), ("rat", "car"), ("aab", "abb"), ("", "")]:
    print(s, t, anagram_counts(s, t), anagram_sorted(s, t))
set("aab") 和 set("abb") 相同,却丢失了次数,不能据此判断字母重排。
布尔条件、简化与开发习惯
当参数确实是 bool 时,可以直接用 if flag。一般对象的真假值与 flag == True 并不总等价。L05 也讲过:列表上的 += 和 + 可能有不同的输入变化,不能为了缩短代码全部互换。
保留往年建议中的实际检查:明确任务与中间状态,按接口拆函数,完成小功能后测试,复用已有计算,用有含义的变量记录常量,查陌生接口,保留失败输入。函数长度、循环层数或代码简短本身都不保证正确;append() 也有合适的使用场景。
小结
采纳一份实现,需要明确需求、阅读关键逻辑、核对文档和环境、检查边界与副作用,并根据规模评估效率。工具执行和有限测试提供证据,但不能代替其余审查。
格式化工具整理排版,静态检查报告规则问题,print 与调试器帮助定位状态,测试检查具体约定。记录来源、反例、修改和回归结果,才能说明为什么采纳。
下一讲将讨论:同类记录的数据与操作,怎样用类一起组织。
练习
- 找出下列候选在非空和空输入上的失败,并说明缺少的规格。修订约定:空列表返回空字符串;频次并列时返回最先出现的词。自行修正并测试。
def most_common(words: list[str]) -> str: counts = {} for word in words: counts[word] += 1 return max(counts, key=counts.get) - 为“把成绩列表转换为等级列表”写签名、行为说明及至少三个例子。明确分数范围、等级边界、空输入和输入是否改变。
- 按本讲 IPv4 规格,先独立写至少六个测试,再检查 AI 或教师提供的候选。记录预期、实际结果与修正。
- 用课堂
factorial()检查递归与循环版本的等价性,包括 n=0。可以按本周政策请 AI 提供候选,但不得让它改写个人作业 1。 - 在自己 Labs 1–7 的代码上运行 Ruff。解释三项不熟悉的诊断;若不足三项,使用 Lab08 的练习文件,不编造警告。
- 阅读 PEP 8 的 “A Foolish Consistency is the Hobgoblin of Little Minds”,用一句话说明项目一致性、可读性与机械套规则的关系。